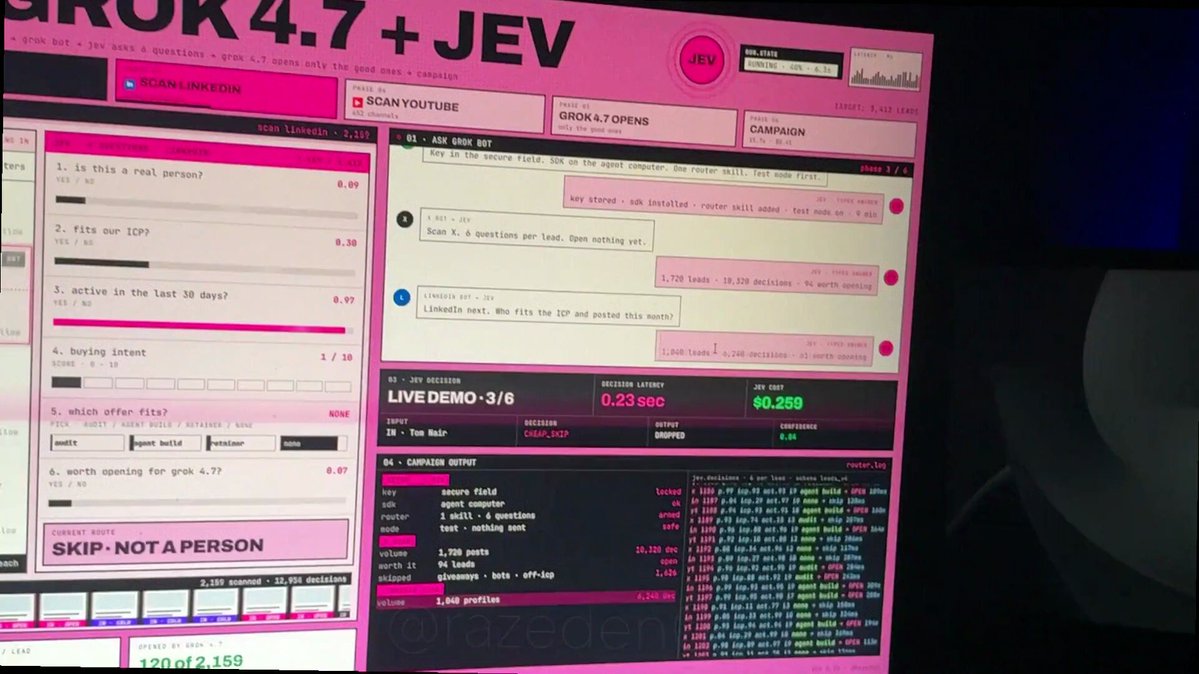
20,472회의 빠른 판단으로 리드 3,412개를 걸러 Grok이 신호가 높은 항목만 처리하도록 하기
 bestjev 홈
Jev 작업 분배 활용 사례
후보 순위 지정, 작업 분류, 맥락 기반 라우팅에 Jev를 적용한 작업 분배 사례 109개를 영상과 원문으로 확인할 수 있습니다.
최종 업데이트
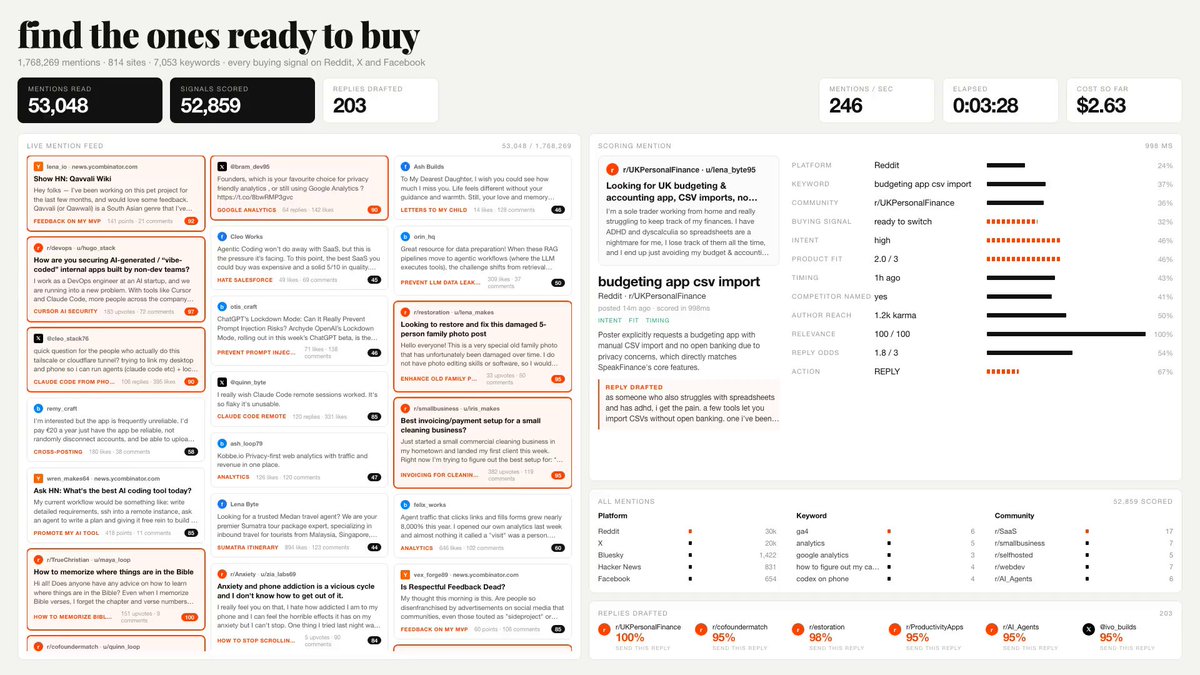
RedReplier 데이터 200만 행을 분류해 품질을 높이면서 이전 구성보다 약 5배 빠르게 처리
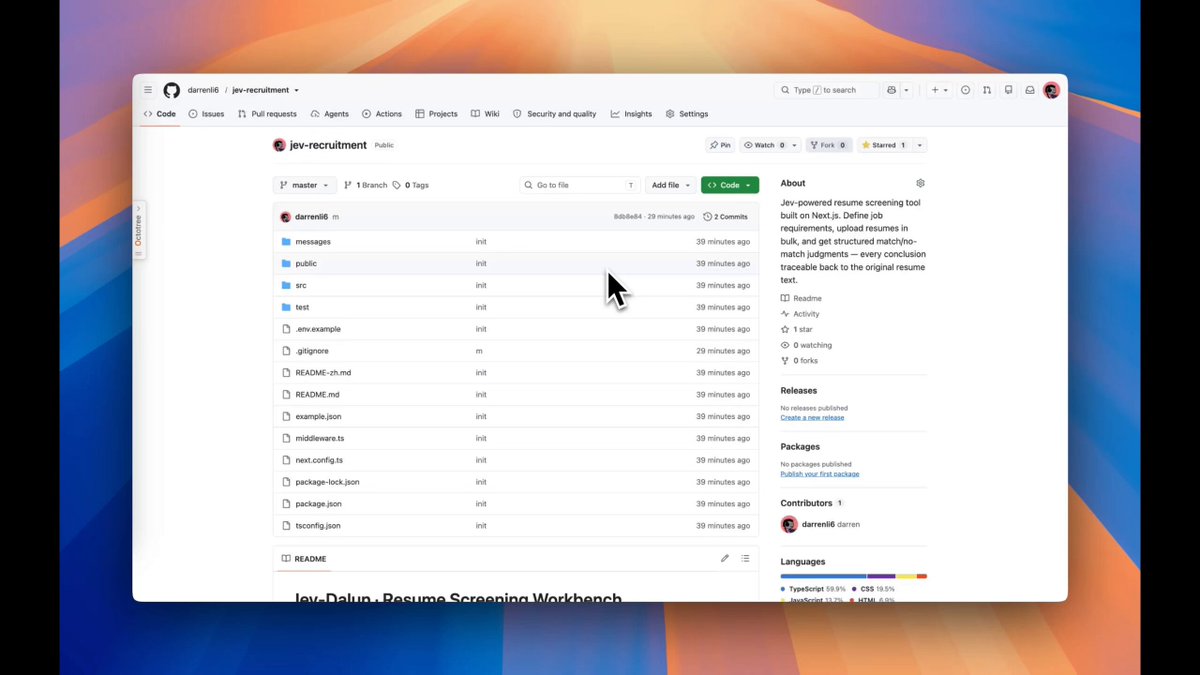
업로드된 이력서를 명확한 조건으로 검사하고 각 판단에 원문 인용을 제시
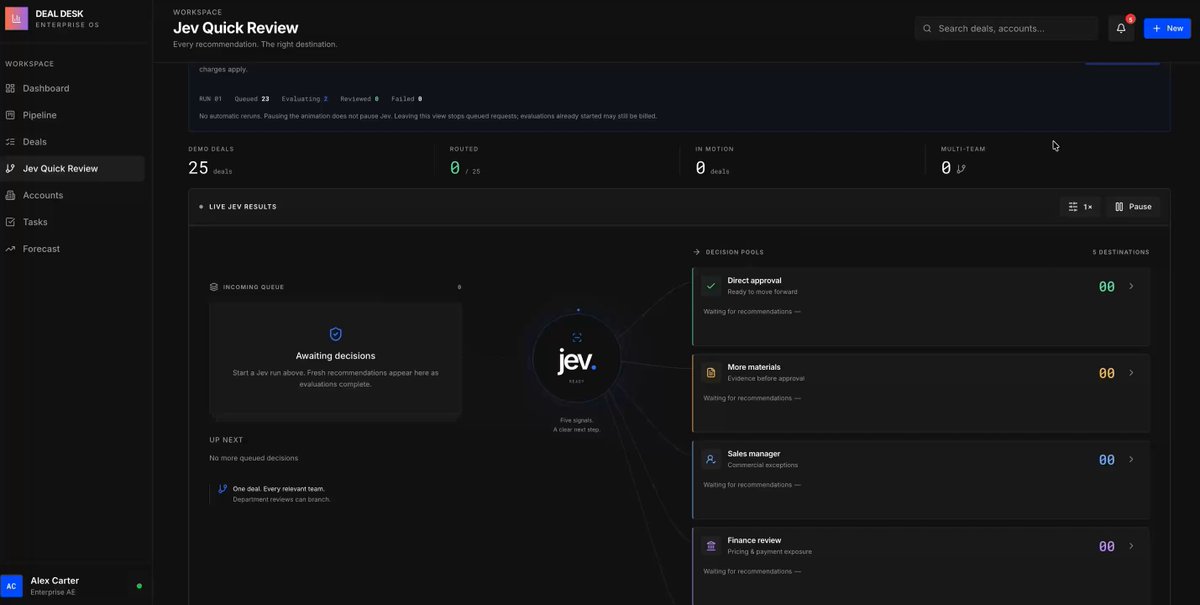
거래를 승인, 추가 문서, 영업·재무·법무 검토로 라우팅하고 최종 판단은 사람에게 맡기기
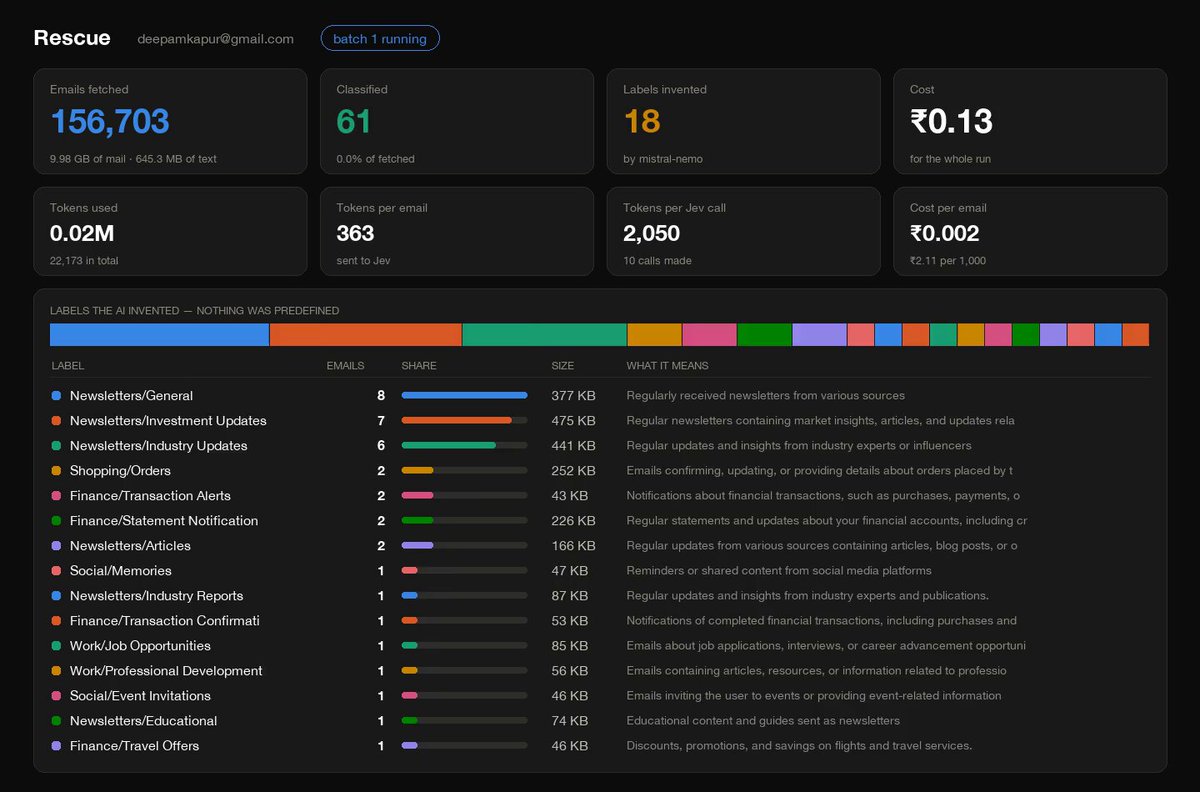
14년간 쌓인 Gmail 156,703개를 읽고 필요하면 라벨을 만들어 90개 범주로 정리
612행 은행 피드에서 Jev와 두 Gemini Flash 모델의 정확도, 시간, 비용을 비교
4개의 타입 지정 티켓 판단을 한 번에 반환해 스트리밍 문장이나 JSON 재파싱 없이 13개를 처리
수신 메일을 정리하고 후속 작업의 우선순위를 정해 매주 약 2~3시간을 절약
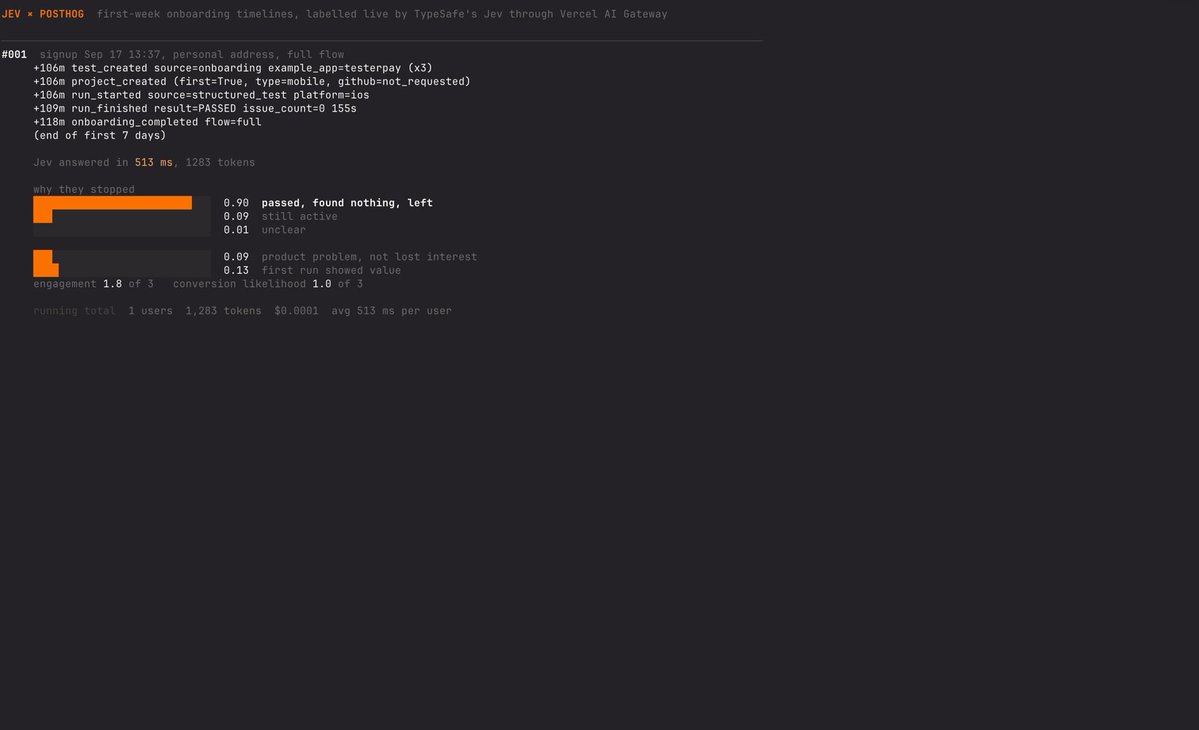
가입자 672명의 첫 주 PostHog 이벤트를 읽고 32초 안에 5개 분류 질문에 답하기
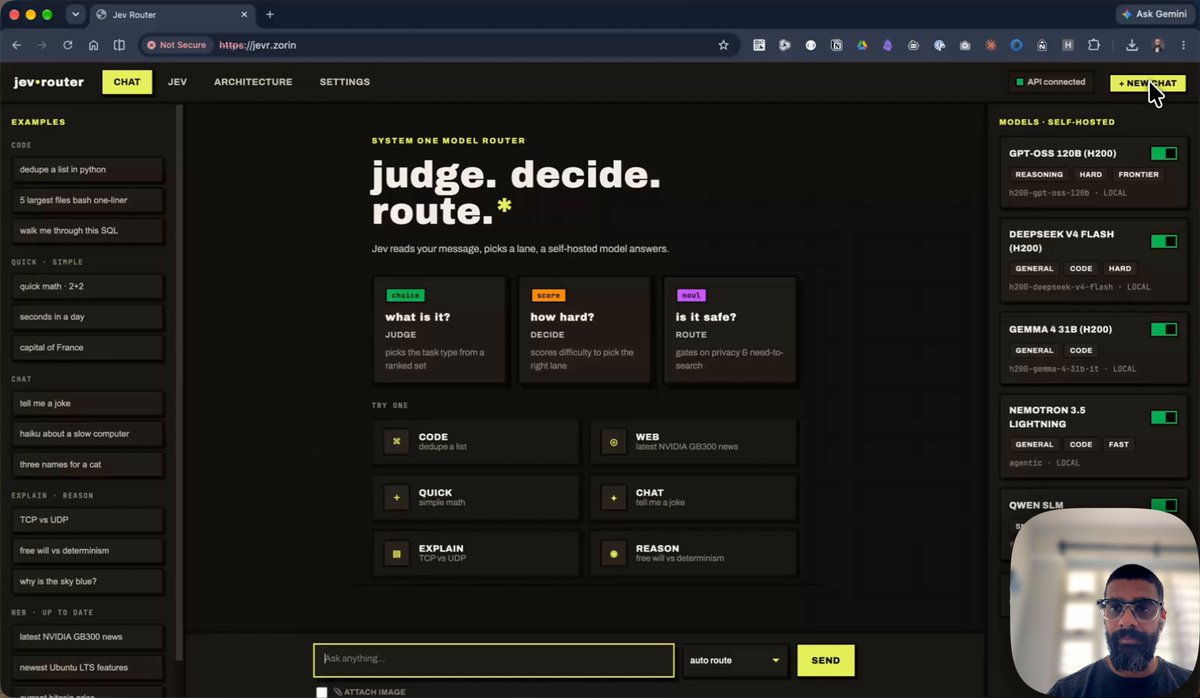
작업, 난이도, 개인정보, 웹 필요성을 4개 확률로 평가한 뒤 적합한 모델로 라우팅
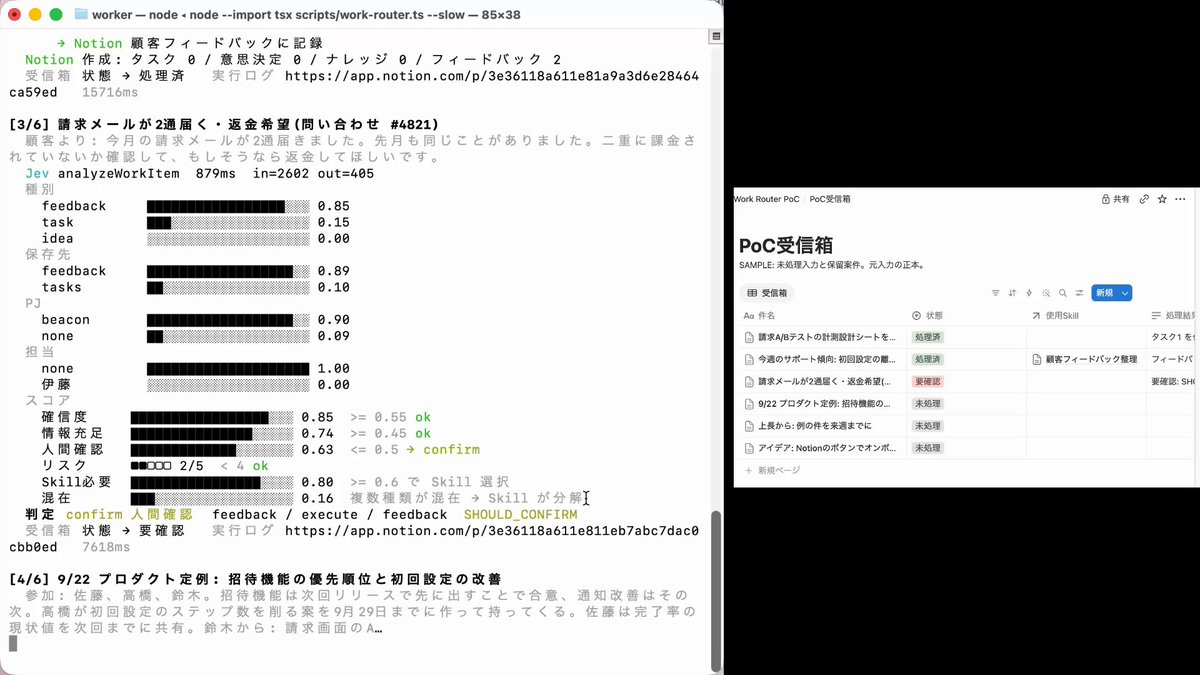
Notion 수신함 메모를 점수화해 신뢰도가 높은 항목만 작업, 의사결정, 지식으로 자동 분류
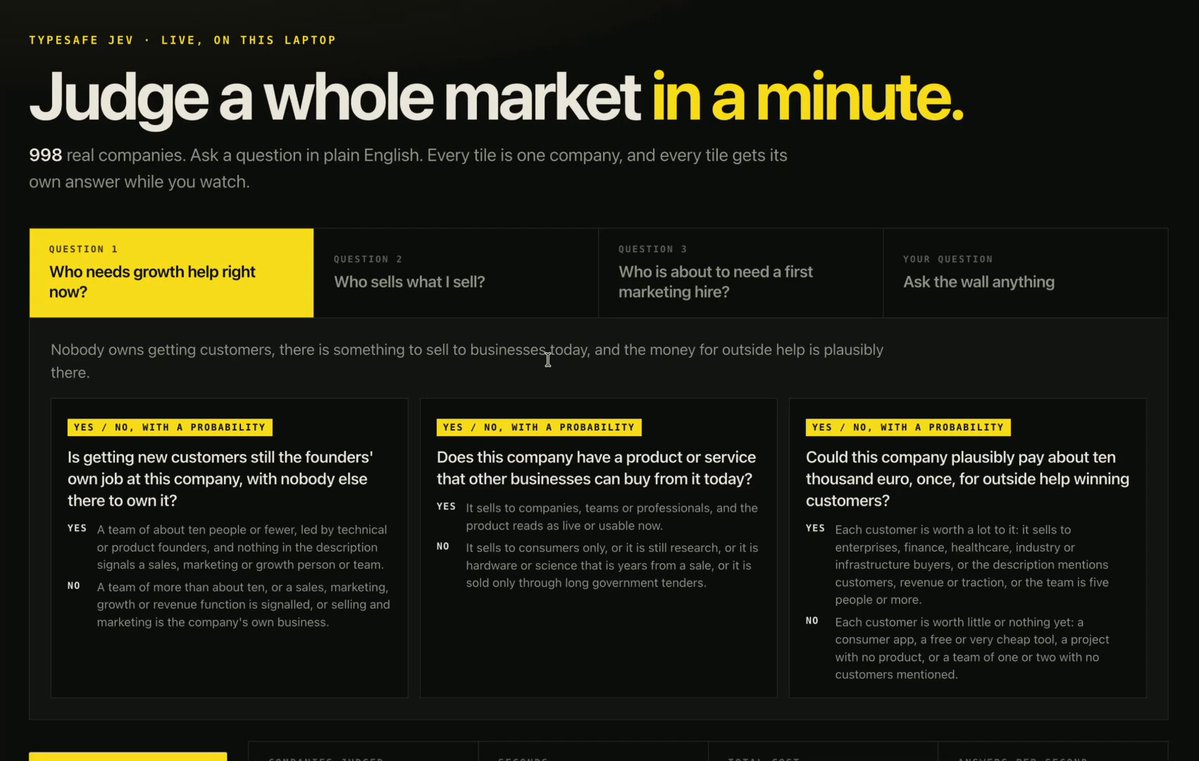
회사 자기소개와 3개 성장 예·아니오 질문만으로 Y Combinator 잠재고객 998개를 22.4초에 분류
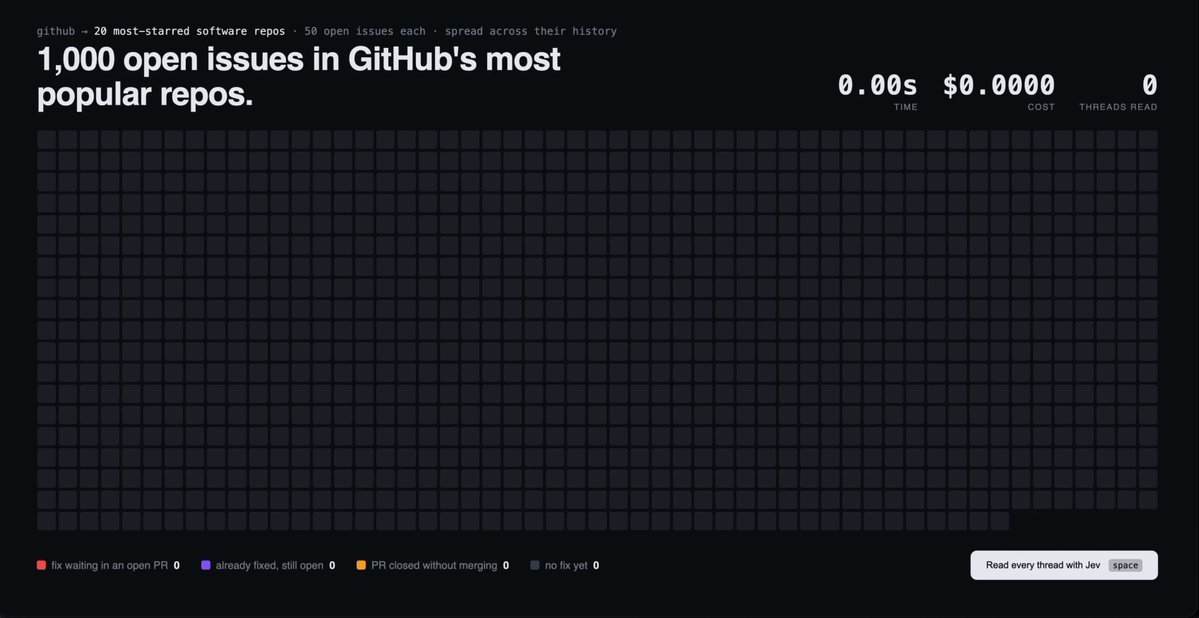
상위 저장소 20개의 GitHub 이슈 1,000개를 8초에 읽어 기존 수정과 정체된 PR을 찾기
심층 분석 전에 연구 링크를 걸러 저가치 스레드가 에이전트 맥락과 토큰을 소모하지 않게 하기
오래된 리드 1,000개를 점수화해 영업 전화 대상을 가치 높은 50개로 축소
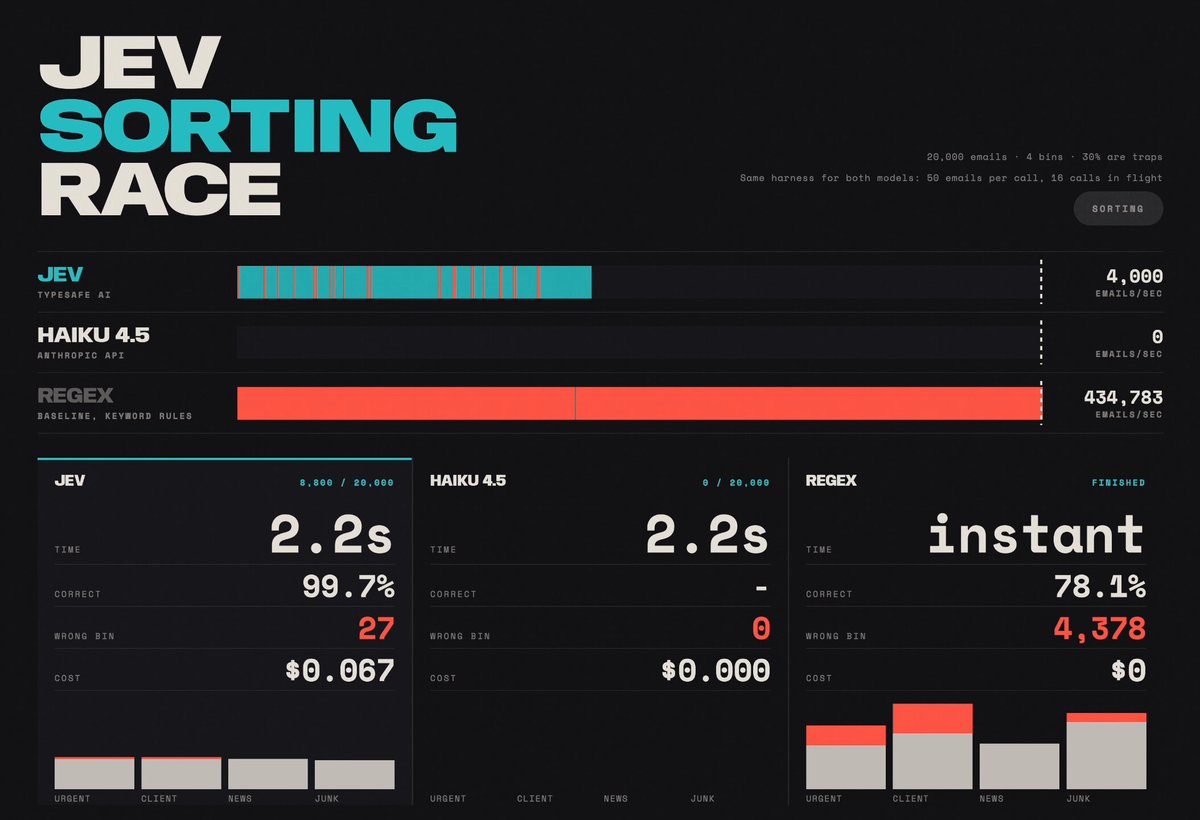
이메일 2만 개를 4.6초와 0.15달러로 4개 범주에 분류해 99.7% 정확도를 보고
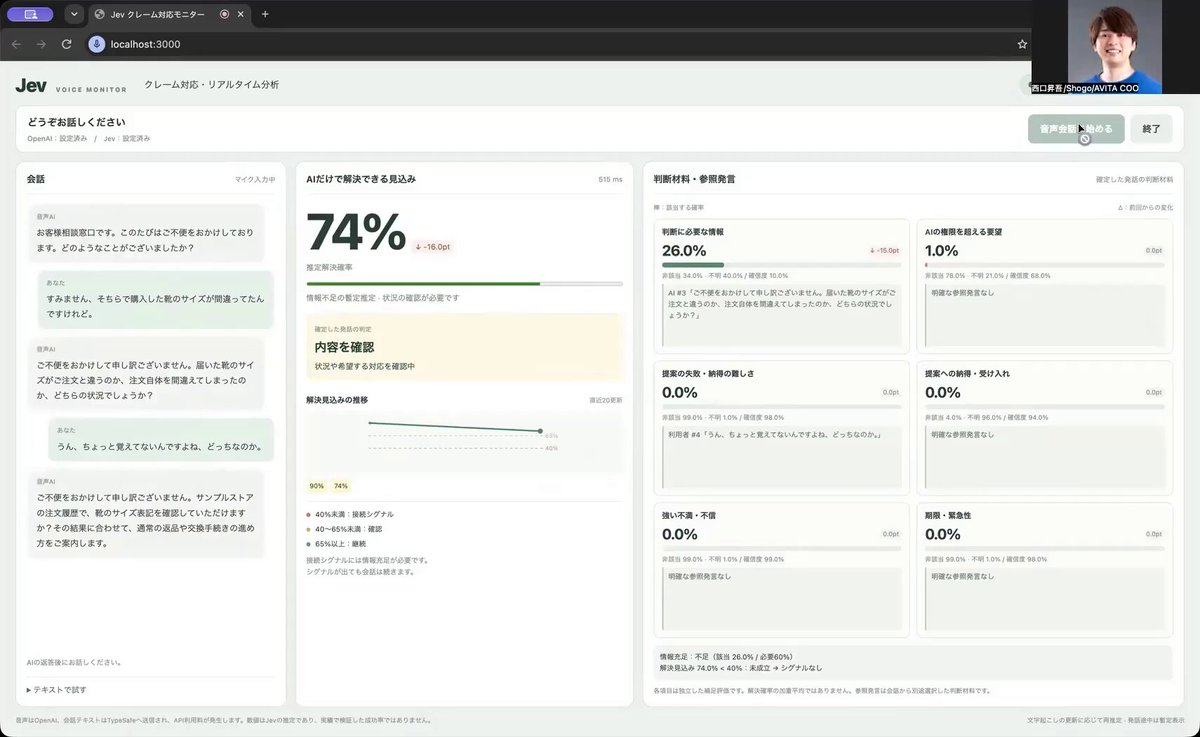
10분 만에 콜센터 데모를 구축해 문의를 AI와 상담원에게 분배
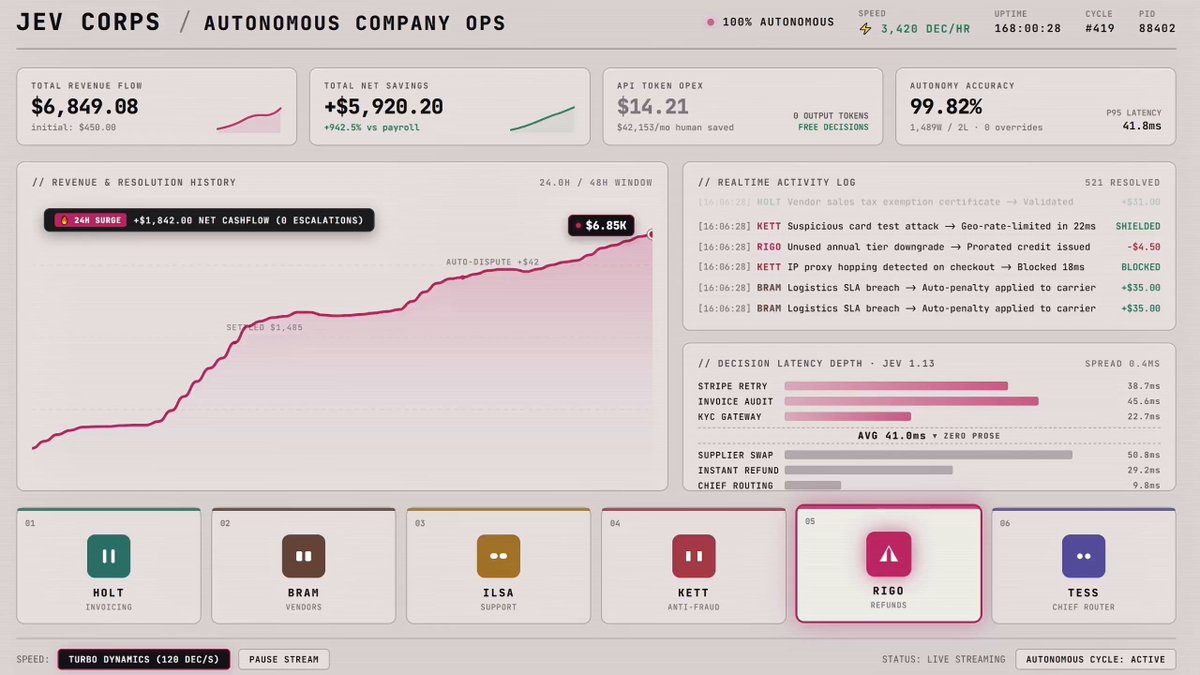
마이크로 에이전트 6개로 회사 운영을 처리하고 48시간 동안 순현금흐름이 150달러에서 6,888달러로 늘었다고 보고
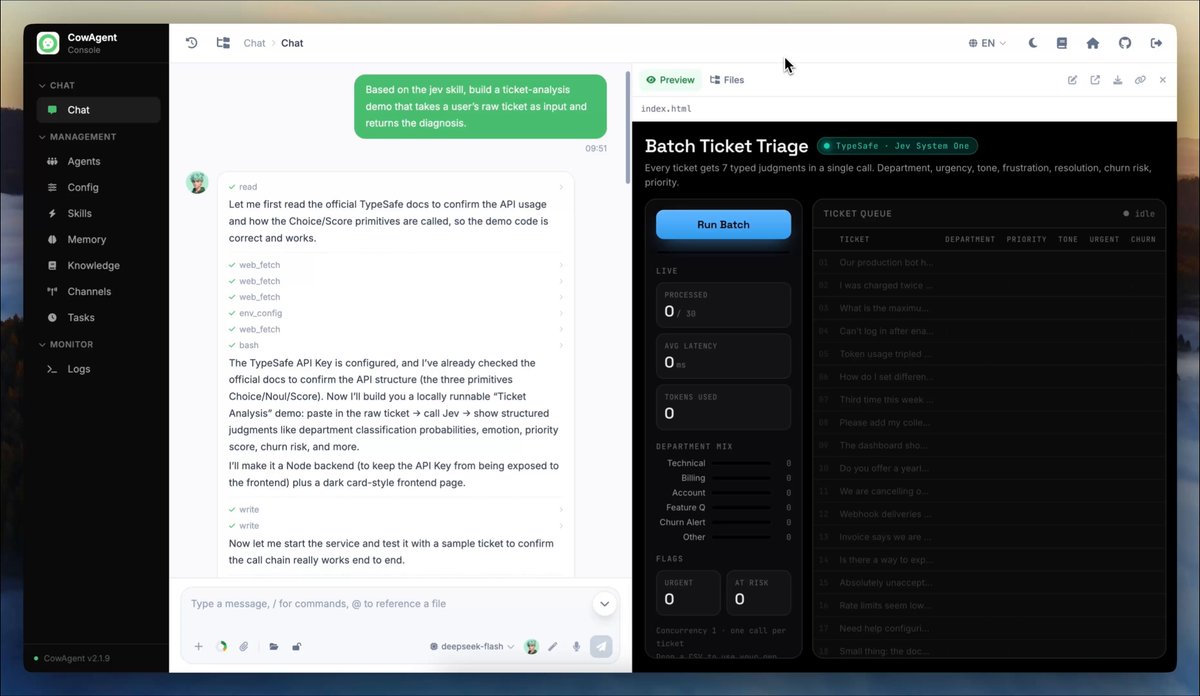
지원 티켓마다 한 번의 호출로 타입 지정 분류, 점수, 불리언 판단 7개를 약 500밀리초에 처리
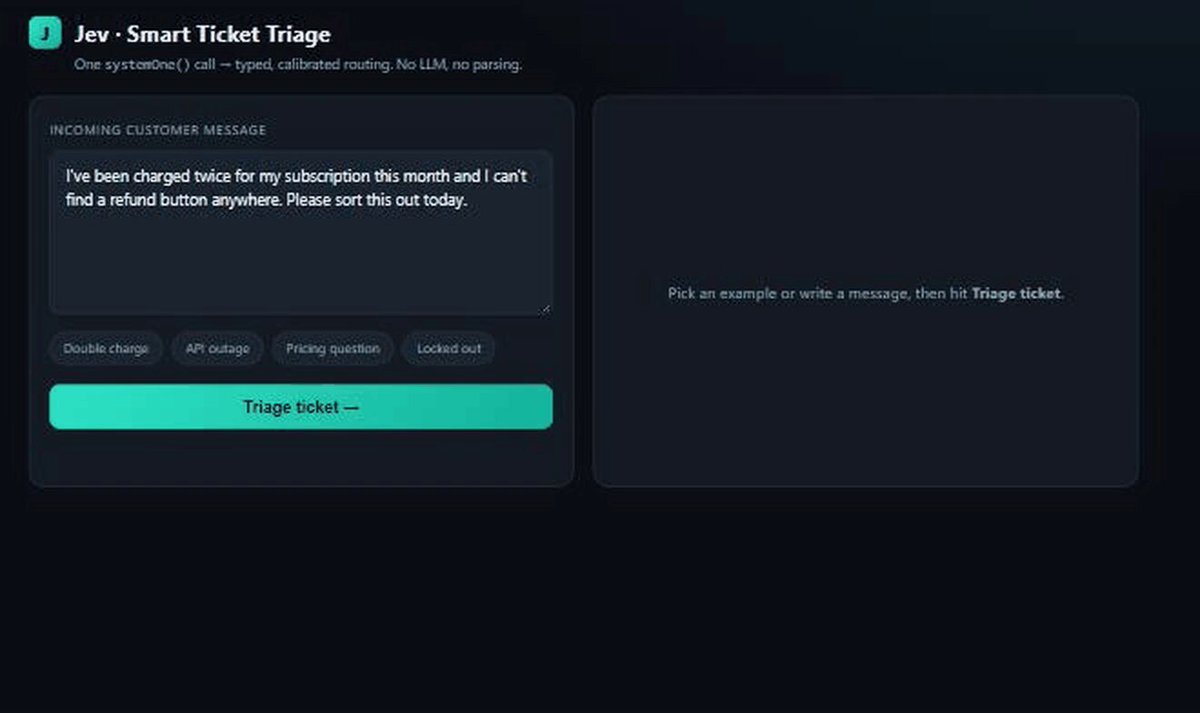
한 번의 호출로 지원 티켓을 팀·긴급도·심각도·고객 감정별로 분류
세 가지 워크플로로 사기 심사·구매 신호 분류·바이럴 콘텐츠 모니터링을 자동화
티켓 담당 부서를 제안하고 불확실한 사례를 검토 대상으로 표시해 라우팅 정확도를 측정
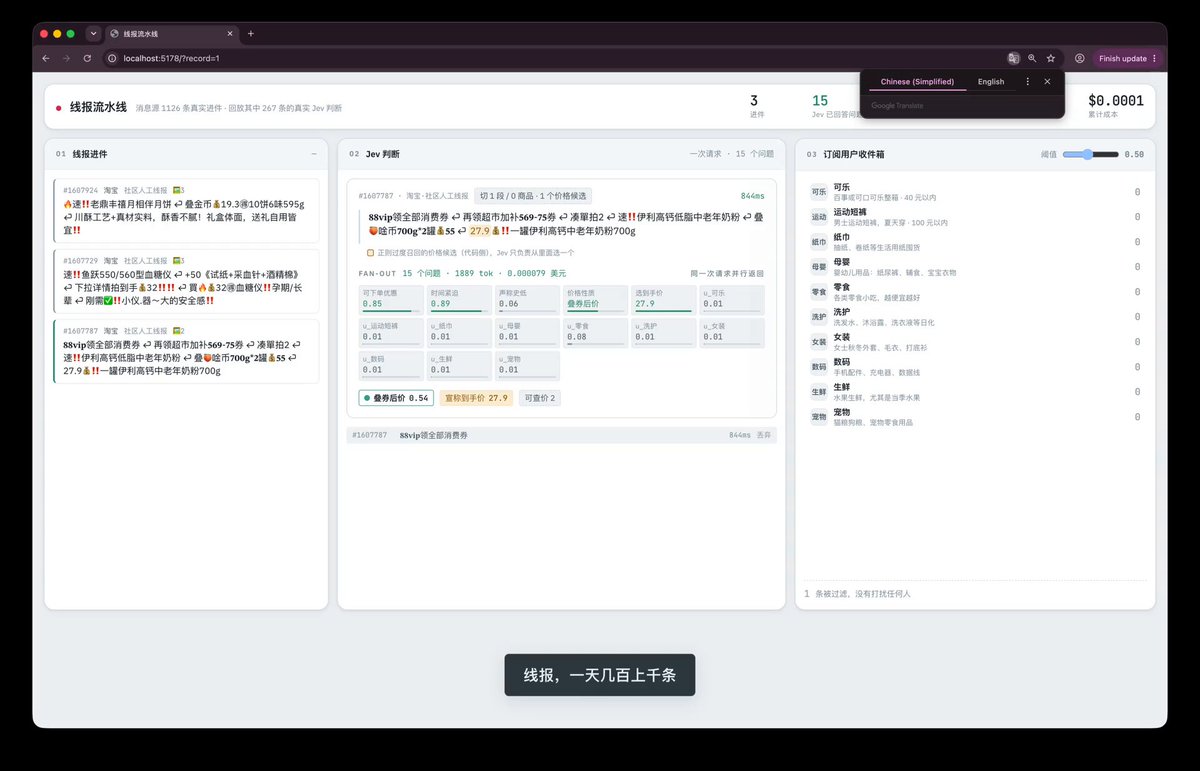
가격 조건에 따라 할인 정보 267개를 감시해 4,005회 판단하고 63.3%는 알림에서 제외
게시물을 70~500ms에 분류하고 이메일을 즉시 선별하며 저신뢰 사례를 로컬 Ollama로 전달
일치하는 데모가 없습니다
다른 키워드를 사용하거나 전체 카테고리로 돌아가세요.